Si te han dicho que necesitas un fichero llms.txt para que ChatGPT, Gemini o Perplexity hablen de tu negocio, te interesa saber qué se ha medido antes de pagar por ello. llms.txt es un fichero de texto que se pone en la raíz de una web (tuweb.com/llms.txt) con un resumen en formato Markdown de lo que hay en ella y enlaces a las páginas importantes. La idea es darle a un modelo de lenguaje una versión limpia y corta de tu web para que no tenga que leer el HTML entero. Es una propuesta de 2024, no un estándar, y hasta hoy ningún buscador ni asistente de IA ha dicho que lo use para decidir a quién cita. Los dos estudios más grandes que existen no encuentran ningún efecto, y la documentación oficial de Google dice que no hace falta ningún fichero especial. Aquí tienes los datos, lo que sí influye y en qué caso concreto puede tener sentido.
Qué es llms.txt y de dónde sale
La propuesta la publicó Jeremy Howard en septiembre de 2024 en llmstxt.org. Nació con un problema concreto en mente: las herramientas de programación con IA tenían que leer documentación técnica llena de menús, anuncios y código de la página, y gastaban mucho espacio de su memoria de trabajo en ruido. Un fichero en Markdown con lo esencial y enlaces a versiones limpias de cada página les ahorraba ese trabajo. Por eso el formato es sencillo: un título, un resumen corto y listas de enlaces agrupadas por secciones. Se parece a un sitemap, pero pensado para que lo lea un modelo y no un buscador. El paso de ahí a "llms.txt te hace salir en ChatGPT" lo dio después el mercado del posicionamiento, no la propuesta. En ella no se promete nada sobre citas ni sobre visibilidad en asistentes: es una forma de ordenar documentación para quien quiera usarla.
Un ejemplo mínimo tiene esta pinta:
# Nombre de tu negocio

> Qué haces, para quién y dónde, en una o dos frases.

## Servicios

- [Servicio uno](https://tuweb.com/servicio-uno/): qué incluye
- [Servicio dos](https://tuweb.com/servicio-dos/): qué incluye

## Información

- [Contacto y horario](https://tuweb.com/contacto/)
Qué dicen los datos
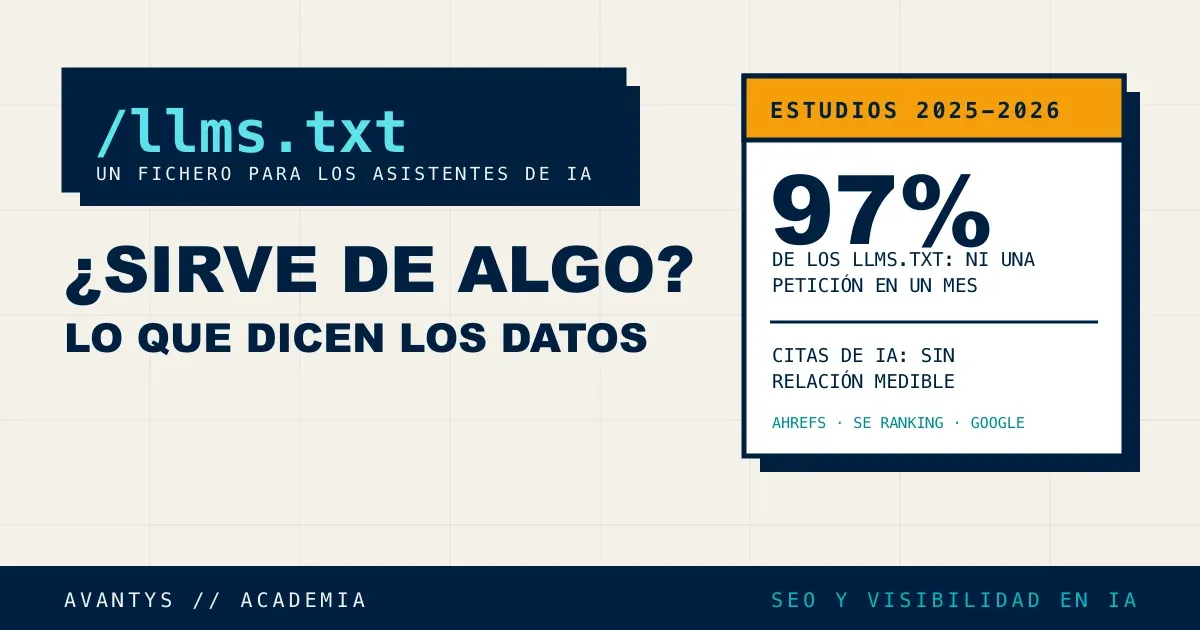
Hay dos estudios grandes y una postura oficial, y apuntan en la misma dirección. Ahrefs revisó 137.000 sitios y vio que el 28 % publicaba un llms.txt válido, pero que el 97 % de esos ficheros no recibió ni una sola petición en todo un mes. De las pocas visitas que llegaban, la mayoría eran herramientas de auditoría SEO, rastreadores genéricos y bots sin identificar; los bots de búsqueda con IA eran una parte mínima (estudio de Ahrefs). SE Ranking analizó unos 300.000 dominios, de los que un 10 % tenía el fichero, y cruzó eso con la frecuencia con la que cada dominio aparecía citado en respuestas de los principales asistentes. No encontró relación, ni con pruebas estadísticas ni con un modelo de aprendizaje automático: de hecho, el modelo acertaba más cuando se le quitaba ese dato (estudio de SE Ranking).
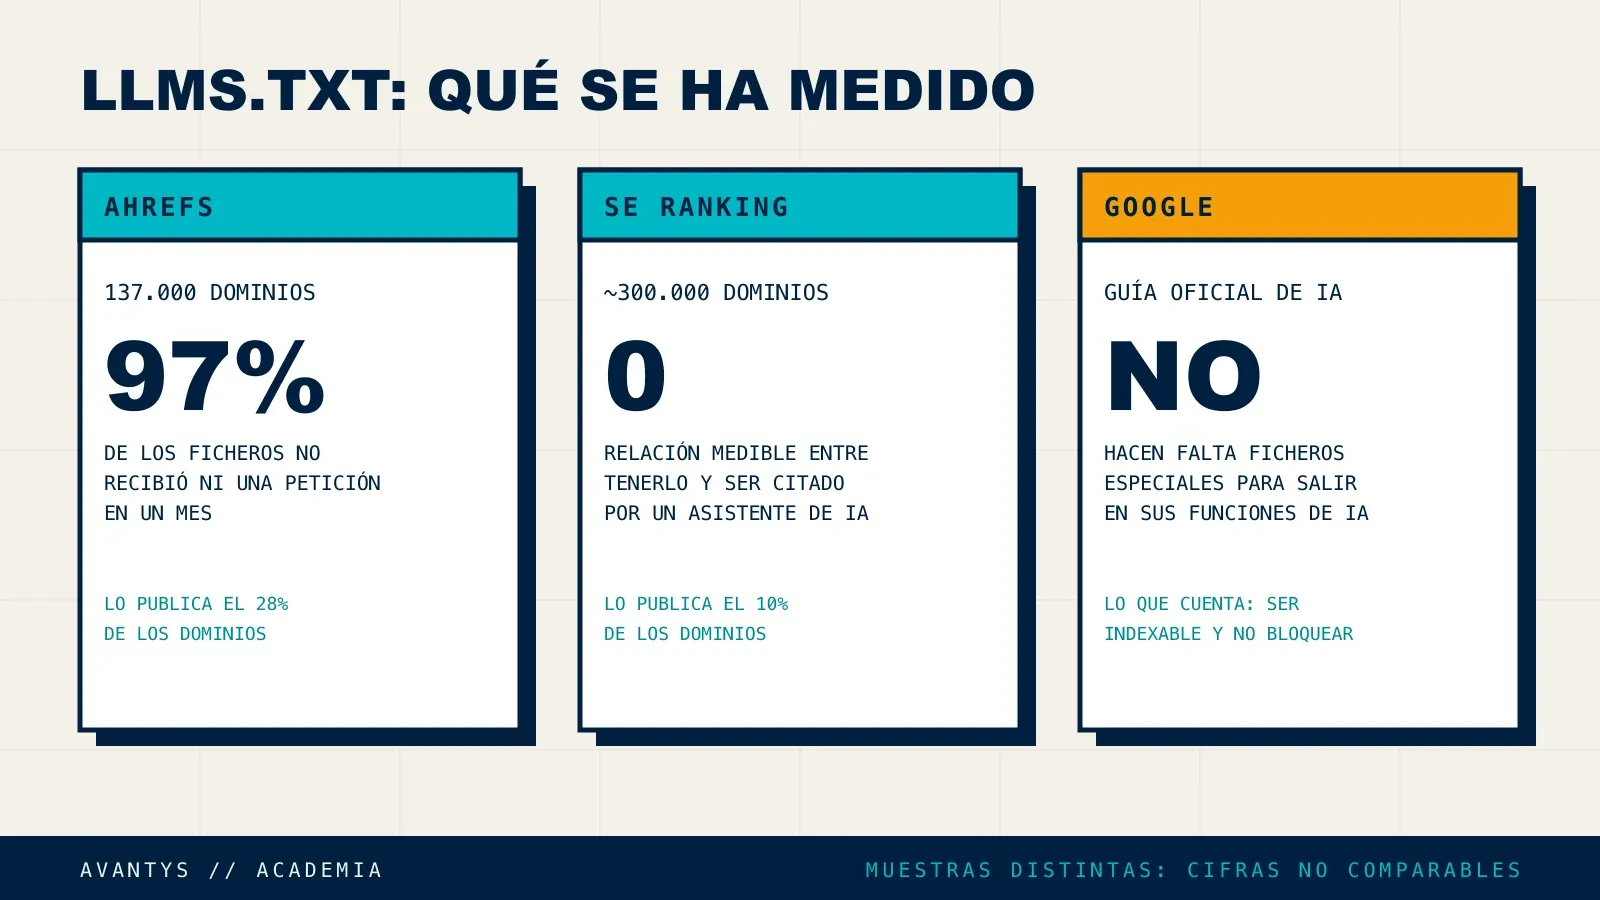
Las cifras de adopción de los dos estudios no coinciden (28 % frente a 10 %) porque las muestras son distintas. Lo que coincide es la conclusión: tener el fichero no se traduce en más citas.
Lo que dice Google
Google tiene una página oficial sobre cómo aparecer en sus funciones de IA, como los resúmenes que salen encima de los resultados. Allí dice, de forma explícita, que no necesitas crear ficheros legibles por máquinas, ficheros de texto para IA ni marcado especial para aparecer en ellas: basta con que tu página se pueda indexar y sea apta para mostrar un fragmento en la búsqueda normal (Google Search Central, funciones de IA). John Mueller, de Google, fue más allá en una respuesta pública y lo describió como algo especulativo por ahora (Search Engine Journal). OpenAI, Anthropic y Perplexity documentan sus rastreadores y cómo bloquearlos, pero ninguno menciona llms.txt como señal para citar una web.
Lo que sí influye para que un asistente te cite
Si el objetivo es aparecer en respuestas de IA, el trabajo que cuenta es el mismo que el del posicionamiento de siempre, más una condición técnica que muchas webs incumplen sin saberlo. La condición es no bloquear a los rastreadores. Muchos cortafuegos, plugins de seguridad y servicios como Cloudflare bloquean por defecto a los bots de IA, y una web que no se puede leer no se puede citar. Lo siguiente es que tus páginas sean indexables en Google y en Bing, porque varios asistentes buscan a través de ellos. Y después viene el contenido: respuestas claras a preguntas concretas, en bloques que se entiendan solos, con datos propios y con tu negocio bien identificado (quién eres, dónde estás, qué haces). Nada de eso lo resuelve un fichero en la raíz. Lo resuelve una web que se deja leer y que dice algo que merezca la pena citar.
- No bloquees a los bots que quieres que te lean. Revisa tu robots.txt y tu cortafuegos. Lo explicamos en Robots.txt: cómo controlar el rastreo de Google.
- Sé indexable. Un "noindex" olvidado te saca de Google y, con él, de muchos asistentes.
- Escribe para ser citado. La estrategia completa está en Qué es el GEO.
Cuándo puede tener sentido crear un llms.txt
Hay un caso en el que sí tiene lógica: si publicas documentación técnica que usan programadores con herramientas de IA (una API, un software, un plugin). Ahí es donde nació la propuesta, y el estudio de Ahrefs vio que las herramientas de programación con IA piden estos ficheros más que los buscadores. Para una web de empresa, una tienda o un blog, el coste de crearlo es bajo, pero el beneficio medido hasta hoy es cero. Si lo haces, que sea sabiendo que es una apuesta y no una mejora comprobada, y sin pagar a nadie que te lo venda como la llave de ChatGPT. Si ya lo tienes, tampoco hay motivo para quitarlo: no se ha visto que perjudique. Y conviene volver a mirar los datos cada cierto tiempo, porque si algún asistente empieza a usarlo de verdad, lo documentará.
Preguntas frecuentes
¿llms.txt mejora el posicionamiento en Google?
No. Google dice en su documentación que no hacen falta ficheros especiales para aparecer en sus funciones de IA, y llms.txt no interviene en la búsqueda normal.
¿ChatGPT o Perplexity leen llms.txt?
Ninguno lo documenta como señal para citar una web. El estudio de Ahrefs vio que la mayoría de los ficheros no recibe ninguna visita, y el de SE Ranking no encontró relación entre tenerlo y ser citado.
¿Es lo mismo llms.txt que robots.txt?
No. robots.txt dice a los rastreadores qué pueden visitar y es un estándar que respetan los buscadores. llms.txt es un resumen opcional de tu web para modelos de lenguaje y nadie está obligado a leerlo.
¿Me puede perjudicar tenerlo?
No se ha visto ningún efecto negativo. El único riesgo real es pagar por él pensando que te hará aparecer en la IA.
Conclusión
llms.txt es una buena idea para documentación técnica y una promesa sin datos para todo lo demás. Si quieres que los asistentes de IA te encuentren, empieza por lo que sí se puede comprobar: que tu web no bloquee a sus rastreadores, que esté indexada y que responda con claridad a lo que pregunta tu cliente. Si prefieres que lo revisemos contigo, en Crece nos encargamos de la visibilidad de tu negocio.
Guías relacionadas:
Impulsa tu Negocio
Estrategias de marketing digital que convierten visitas en clientes.