Revisado en septiembre de 2026.
La respuesta corta: el modelo entero tiene que caber
Para saber cuánta VRAM necesitas, suma tres cosas: lo que ocupa el modelo, un margen de funcionamiento y la memoria que gasta el texto que le pasas. La VRAM es la memoria de la tarjeta gráfica, la GPU. Es rápida y está pegada al chip que hace los cálculos, y por eso manda: si el modelo cabe entero en ella, responde con fluidez. Si no cabe, el programa reparte una parte en la memoria normal del equipo (la RAM) y la otra en la tarjeta, y todo va bastante más lento, porque el trabajo se queda esperando a la pieza más lenta. Herramientas como Ollama te lo enseñan sin disimulo: su documentación explica que el comando ollama ps muestra algo como "48%/52% CPU/GPU" cuando el modelo no cabe en la tarjeta. Si ves eso, tu máquina se ha quedado corta. Como orientación: un modelo de 8B comprimido cabe en una tarjeta de entrada, y uno de 70B comprimido necesita una tarjeta profesional grande si quieres pasarle documentos largos. Abajo tienes la tabla y las cuentas.
Las cifras de esta guía son orientativas. Salen de fuentes comunitarias que citamos en cada caso, y cambian según el modelo concreto y el programa con el que lo ejecutes. Sirven para no equivocarte de gama, no para afinar al giga.
Qué son los parámetros (el "8B" del nombre)
Los modelos de lenguaje se venden con un número y una B: 8B, 14B, 32B, 70B. La B es de "billion" en inglés, que aquí son mil millones. Un modelo de 8B tiene 8.000 millones de parámetros, y uno de 70B tiene 70.000 millones. Un parámetro es un número que el modelo aprendió durante su entrenamiento, y cada uno ocupa sitio en memoria. De ahí la regla de fondo: cuantos más parámetros, más memoria.
Más parámetros suele traducirse en respuestas mejores, sobre todo en tareas que piden razonar o seguir instrucciones largas. Pero no siempre compensa. Un modelo pequeño bien elegido puede resolver de sobra una tarea concreta, como clasificar correos o resumir actas, y gastar una fracción de la memoria. Por eso esta decisión empieza por la tarea, no por la tarjeta.
La cuantización, dicho claro
Cuantizar es comprimir el modelo guardando cada parámetro con menos precisión. A cambio de perder algo de calidad, ocupa mucho menos. Vas a ver tres etiquetas:
- FP16: el modelo casi tal cual sale del entrenamiento. Dos bytes por parámetro. Es la referencia de calidad y la que más memoria pide.
- Q8: comprimido a la mitad, más o menos un byte por parámetro. La pérdida de calidad suele ser pequeña.
- Q4 (en la práctica, la variante Q4_K_M, que es la habitual al descargar modelos para uso local): comprimido a algo más de la cuarta parte. Es el punto de equilibrio más usado: el modelo cabe en tarjetas mucho más pequeñas y la calidad aguanta bien en la mayoría de usos.
Hay compresiones todavía más agresivas. Esta guía de requisitos de VRAM menciona que con Q2 un 70B entra en 24 GB, pero con peor calidad que en Q4. Para empezar, Q4 es la opción sensata. Si notas que el modelo se equivoca en tareas que otro más grande resuelve bien, la solución suele ser subir de tamaño antes que bajar de compresión.
La tabla: VRAM por tamaño y cuantización
Estas son las cifras de memoria solo para los pesos del modelo, es decir, el modelo cargado y quieto, sin contar el margen ni el texto que le pases. Están tomadas de esta guía de requisitos de VRAM para LLM:
| Tamaño del modelo | Q4 (Q4_K_M) | Q8 | FP16 |
|---|---|---|---|
| 8B | 4,6 GB | 8 GB | 16 GB |
| 14B | 8 GB | 14 GB | 28 GB |
| 32B | 18,2 GB | 32 GB | 64 GB |
| 70B | 39,9 GB | 70 GB | 140 GB |
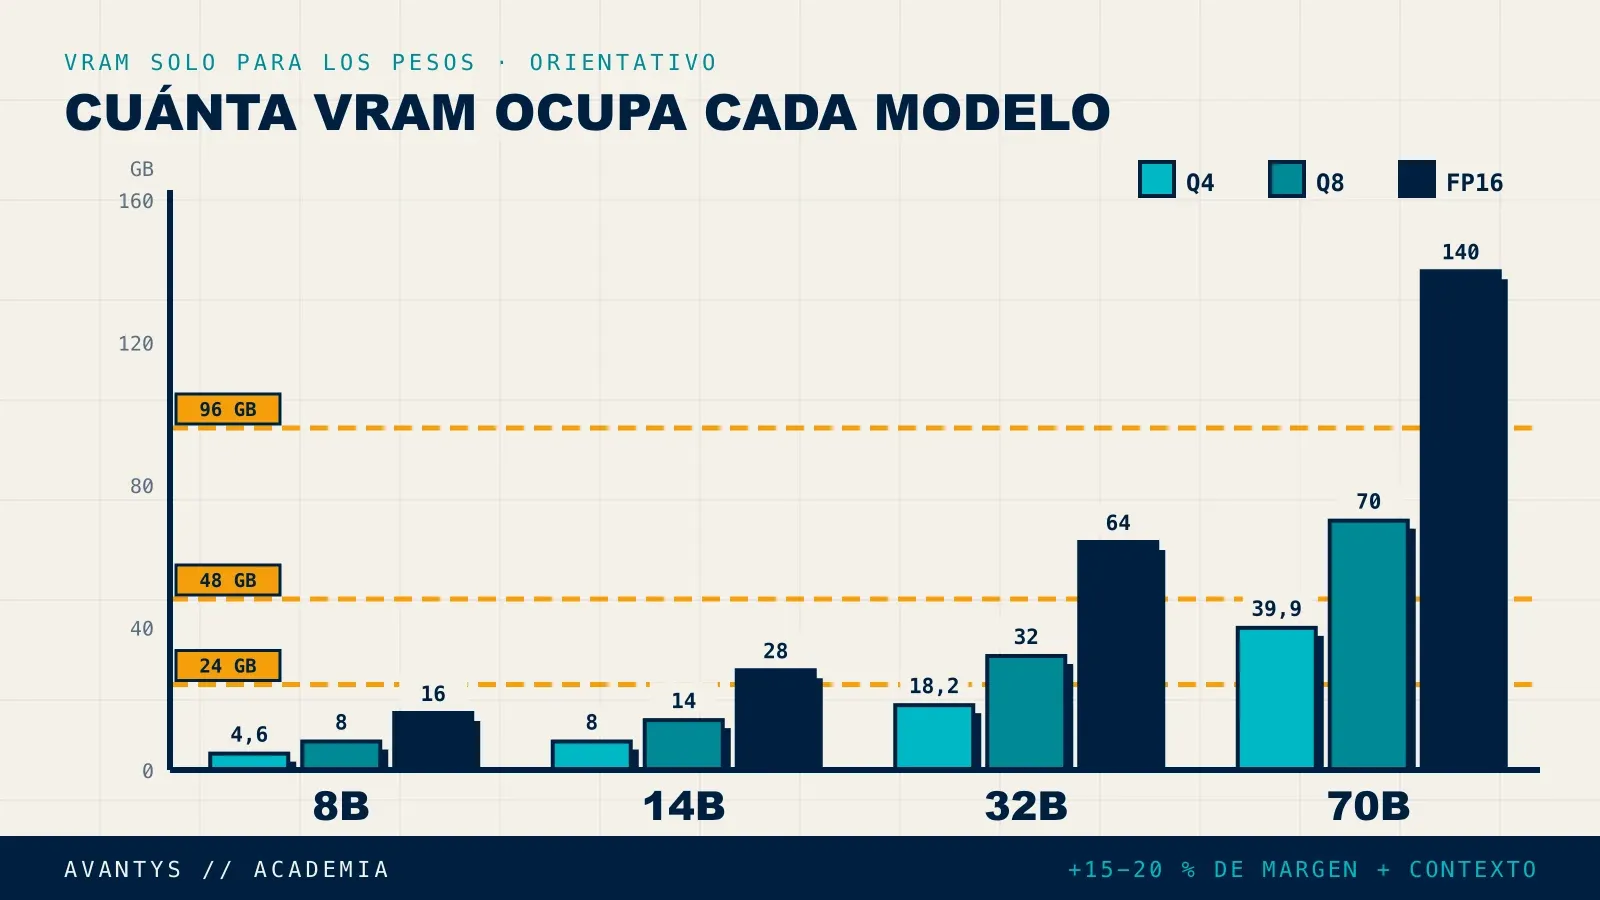
La otra fuente que consultamos da cifras parecidas en Q4: unos 5 GB para 7B-8B, unos 9 GB para 13B-14B, unos 22 GB para 34B y unos 40 GB para 70B. Que dos fuentes independientes coincidan en el orden de magnitud es lo que te interesa: no vas a acertar al decimal, pero sí vas a acertar la gama.
La regla rápida para modelos que no están en la tabla
Si te encuentras un modelo de otro tamaño, divide las cifras de la tabla por el número de parámetros y sale una regla que puedes llevar en la cabeza:
- Q4: unos 0,6 GB por cada mil millones de parámetros.
- Q8: alrededor de 1 GB por cada mil millones.
- FP16: alrededor de 2 GB por cada mil millones.
Un modelo de 24B en Q4 pediría entonces unos 14-15 GB solo de pesos. A eso le sumas el margen y el contexto, que vemos ahora.
Un aviso sobre reglas que circulan por internet. La guía de mustafa.net propone "añadir unos 1,2 GB por cada mil millones de parámetros en Q4_K_M", pero su propia tabla da unos 40 GB para un 70B, que es menos de la mitad de lo que saldría con esa regla (unos 84 GB). No encaja con sus cifras ni con las de la otra fuente, así que no la usamos. Lo que sí compartimos de esa guía es su consejo práctico: dejar siempre 1-2 GB libres para el contexto y el sistema. Es un buen ejemplo de por qué conviene cruzar fuentes antes de comprar nada.
El margen de funcionamiento
La tabla de arriba es el modelo quieto. Para que funcione, el programa que lo ejecuta necesita memoria extra: espacio de trabajo para los cálculos, lo que reserva el propio controlador de la tarjeta y huecos que quedan sin aprovechar. La guía de techsy.io recomienda sumar entre un 15 % y un 20 % sobre los pesos para cubrir todo eso.
Con las cuentas hechas, queda así:
| Modelo | Pesos | Con 15-20 % de margen |
|---|---|---|
| 8B en Q4 | 4,6 GB | 5,3–5,5 GB |
| 14B en Q4 | 8 GB | 9,2–9,6 GB |
| 32B en Q4 | 18,2 GB | 20,9–21,8 GB |
| 70B en Q4 | 39,9 GB | 45,9–47,9 GB |
| 70B en Q8 | 70 GB | 80,5–84 GB |
Fíjate en el 70B en Q4: sin haberle pasado todavía ni una línea de texto, ya ronda los 46-48 GB. Una tarjeta de 48 GB se queda justa antes de empezar.
El contexto: por qué un documento largo dispara la memoria
El contexto es todo el texto que el modelo tiene delante mientras responde: tu pregunta, el documento que le pegas y la conversación anterior. Se mide en tokens, que son trozos de palabra (en la práctica, algo menos de una palabra cada uno). Para no recalcular todo desde cero con cada palabra nueva, el modelo guarda en la VRAM una memoria intermedia de ese texto, la llamada caché KV. Y esa caché crece con el tamaño del texto.
Con un chat corto apenas se nota. Con un contrato, un manual o varios informes a la vez, se come la tarjeta. Estas son las cifras que da la guía de techsy.io para un modelo de 70B (Llama 3.3 70B), aparte de los 39,9 GB de pesos en Q4:
| Contexto | Caché KV aproximada | Qué es, más o menos |
|---|---|---|
| 8.000 tokens | ~2,6 GB | Unas cuantas páginas |
| 32.000 tokens | ~10 GB | Un documento largo |
| 128.000 tokens | ~41 GB | Un libro corto o una carpeta de documentos |
Con 128.000 tokens, la caché ocupa más que el propio modelo comprimido. Cada modelo gasta distinto (depende de cómo esté construido), pero la idea vale para todos: si tu uso es trabajar con documentos largos, dimensiona para el contexto, no solo para el modelo.
Varios usuarios a la vez
Si la máquina la va a usar un equipo, cada conversación simultánea necesita su propia caché de contexto. La documentación de Ollama lo explica con un ejemplo: con un contexto de 2.000 tokens y 4 peticiones en paralelo, la memoria reservada equivale a un contexto de 8.000. Es decir, la memoria del contexto se multiplica por el número de peticiones que atiendes a la vez.
Hay dos formas de vivir con esto. Una, dimensionar para varias conversaciones simultáneas desde el principio. Dos, atender las peticiones de una en una y aceptar que alguien espere unos segundos. Para un equipo pequeño que consulta de vez en cuando, lo segundo suele bastar. Para un asistente abierto a toda la empresa, no.
Otras cargas que comparten la tarjeta
La tarjeta no tiene por qué ser solo del modelo de texto. Si en la misma máquina quieres transcribir audio o generar imágenes, esas cargas también piden VRAM, y todo tiene que caber a la vez si lo usas a la vez.
Transcribir audio con Whisper. El repositorio oficial de Whisper publica la VRAM aproximada de cada tamaño:
| Modelo de Whisper | Parámetros | VRAM aproximada |
|---|---|---|
| tiny | 39 millones | ~1 GB |
| base | 74 millones | ~1 GB |
| small | 244 millones | ~2 GB |
| medium | 769 millones | ~5 GB |
| turbo | 809 millones | ~6 GB |
| large | 1.550 millones | ~10 GB |
Si piensas transcribir reuniones y luego resumirlas con un modelo de texto en la misma tarjeta, suma las dos cifras. Lo contamos con más detalle en cómo transcribir audio con Whisper en tu servidor.
Generar imágenes. Los modelos de imagen también cargan sus pesos en la VRAM, y lo que ocupan varía mucho según el modelo y la resolución que pidas. No te damos una cifra única porque no la hay. Si esta carga va a convivir con el modelo de texto, mídela con tu configuración real antes de decidir la tarjeta.
Qué tarjeta te hace falta, por gamas
Juntando pesos, margen y contexto, esta es la orientación por gamas de memoria. No hablamos de modelos de tarjeta concretos: lo que decide es la VRAM.
| Gama | VRAM | Qué cabe con comodidad |
|---|---|---|
| Entrada | 8–12 GB | Un 8B en Q4 con margen; un 14B en Q4 muy justo en 12 GB |
| Media | 16–24 GB | Un 14B en Q4 u Q8; un 32B en Q4 justo en 24 GB, con documentos cortos |
| Alta | 32–48 GB | Un 32B en Q4 con contexto largo; un 32B en Q8 en 48 GB. Un 70B en Q4 no cabe con holgura |
| Profesional grande | 80–96 GB | Un 70B en Q4 con documentos largos; un 70B en Q8 con contexto corto |
| Varias tarjetas | Más de 96 GB entre todas | Un 70B en FP16 (140 GB solo de pesos) o varios modelos a la vez |
El ejemplo del 70B en una tarjeta de 96 GB. Los pesos en Q4 son 39,9 GB. Con el 15-20 % de margen, unos 46-48 GB. Con un contexto de 32.000 tokens (unos 10 GB) llegas a unos 56-58 GB, y te sobra sitio para una segunda conversación o para Whisper. Incluso con 128.000 tokens (unos 41 GB), el total ronda los 87-89 GB y todavía cabe. En una tarjeta de 48 GB, ese mismo modelo no pasaría de contextos cortos.
Lo que esta guía no te cuenta
Elegir la tarjeta es la mitad del trabajo. La otra mitad empieza el día que la máquina se enciende, y es la que más se descuida.
- Actualizar sin romper. Los controladores de NVIDIA tienen dos partes: la que se carga en el sistema al arrancar y las librerías que usan los programas. Si una actualización automática cambia una y la otra sigue en memoria, el modelo deja de ver la tarjeta y aparece el error "Failed to initialize NVML: Driver/library version mismatch". NVIDIA lo documenta en su artículo de soporte sobre este error: la versión del controlador en marcha no coincide con la de las librerías, y lo habitual es reiniciar o recargar el controlador. Lo sensato es controlar cuándo se actualiza y no dejarlo a la suerte.
- Cerrar el modelo a internet. Un modelo local expuesto sin control es una puerta abierta a tu máquina y a lo que le pases. Debe responder solo a quien tú decidas.
- Vigilar memoria y temperatura. Una tarjeta que trabaja muchas horas se calienta, y una memoria que va llena al límite acaba cayéndose en el peor momento. Hay que mirarlo antes de que falle.
- Copias. De la configuración, de los modelos que has ajustado y de los documentos que les das de comer. Si la máquina se pierde, rehacerla desde cero cuesta días.
Si prefieres no encargarte tú, elegimos la máquina, la montamos y la mantenemos nosotros. Tú usas la IA; las actualizaciones, la vigilancia y las copias son cosa nuestra.
Cómo lo decidimos nosotros
No elegimos el modelo por fama ni la tarjeta por lo que usa otra empresa. Hacemos esto:
- Coger diez documentos reales del trabajo que quieres automatizar: los contratos, los informes o los correos de verdad, no ejemplos de internet.
- Probar dos o tres tamaños de modelo en Q4 con esos documentos. Con Ollama se hace en una tarde: te lo explicamos en cómo instalar Ollama en un servidor.
- Quedarnos con el más pequeño que resuelve bien la tarea. Si el 14B acierta igual que el 32B en tus documentos, el 14B es tu modelo.
- Medir el documento más largo que vas a pasarle y cuántas personas lo usarán a la vez. Eso decide el contexto y, con él, la gama de tarjeta.
- Sumar lo que va a compartir la tarjeta (Whisper, imágenes) y dejar margen.
Así eliges con tus datos y no con una tabla de otro. Las cifras de esta guía te dicen en qué gama buscar; tus documentos te dicen dónde quedarte.
Artículos relacionados
- Cómo instalar Ollama en un servidor
- Cómo transcribir audio con Whisper en tu servidor
- Qué datos de tu empresa no deberías compartir con una IA
- Qué tareas automatizar con IA
¿Prefieres no encargarte tú?
Montamos tu IA en un servidor con GPU, la dejamos funcionando y la mantenemos nosotros.