Grabas clases, tutorías o reuniones y luego nadie tiene tiempo de pasarlas a texto. Los servicios en línea lo resuelven, pero cobran por minuto y se llevan la voz de tus alumnos o de tu equipo a un servidor que no es tuyo. Whisper es la alternativa: un modelo de reconocimiento de voz que se instala en tu máquina, transcribe en español y devuelve texto o subtítulos sin que el audio salga de casa. En esta guía te contamos qué modelo elegir, cuánta memoria pide, si te hace falta una tarjeta gráfica y cómo dejarlo trabajando de noche con una carpeta de grabaciones.
Revisado en septiembre de 2026.
Qué es Whisper y por qué se puede instalar en casa
Whisper es un modelo de reconocimiento de voz publicado por OpenAI. Escucha un audio y escribe lo que se dice. También detecta el idioma y puede traducir al inglés. Lo importante para ti: el código y los pesos del modelo (el fichero con lo que el modelo ha aprendido) se publican con licencia MIT. Eso significa que lo descargas, lo instalas en tu servidor y, una vez descargado el modelo, funciona sin conexión con nadie. No hay cuenta, no hay cuota y no hay un tercero escuchando.
Funciona con cualquier audio o vídeo que entienda ffmpeg, la herramienta libre que convierte formatos de audio y vídeo: mp3, m4a, wav, mp4 o la grabación que exporta tu programa de videollamadas.
Si todavía estás decidiendo qué piezas de IA te conviene montar en casa, empieza por la guía de IA privada en tu empresa. Whisper es una de ellas, y de las más agradecidas.
¿Qué tal transcribe en español?
Bien, con matices. La ficha del modelo dice que da resultados sólidos en unos diez idiomas y que el rendimiento varía mucho según la lengua. El README publica la tasa de error de cada idioma en una gráfica, y conviene mirarla antes de decidir. Con una grabación limpia de una persona hablando, el texto sale muy aprovechable.
Los matices importan. La misma ficha avisa de que la precisión cambia con el acento, el dialecto y la persona que habla. Y reconoce dos defectos conocidos: a veces escribe frases que nadie ha dicho (lo que se llama alucinación) y a veces repite texto en bucle. Por eso la transcripción es un borrador muy bueno, no un acta firmada.
Un detalle práctico: dile el idioma. Si no se lo dices, lo detecta con los primeros 30 segundos, y una clase que empieza con música o con ruido puede arrancar mal.
Qué modelo elegir: tamaños y memoria
Whisper viene en seis tamaños. Cuanto más grande, más preciso y más lento, y más memoria de la tarjeta gráfica (la VRAM) necesita. Esta es la tabla del README oficial, con los valores aproximados que publica el proyecto:
| Tamaño | Parámetros | Modelo multilingüe | VRAM necesaria | Velocidad relativa |
|---|---|---|---|---|
| tiny | 39 M | tiny | ~1 GB | ~10x |
| base | 74 M | base | ~1 GB | ~7x |
| small | 244 M | small | ~2 GB | ~4x |
| medium | 769 M | medium | ~5 GB | ~2x |
| large | 1550 M | large | ~10 GB | 1x |
| turbo | 809 M | turbo | ~6 GB | ~8x |
La velocidad es relativa a large y está medida con voz en inglés en una tarjeta de centro de datos: sirve para comparar tamaños, no para calcular cuánto tardará tu clase. Los modelos que acaban en .en solo sirven para inglés, así que para español se usan los multilingües.
Nuestra recomendación de partida es turbo. Es una versión optimizada de large-v3, según el README, más rápida y con una pérdida de precisión mínima, y es el modelo que usa la herramienta por defecto. Tiene una limitación: no traduce. Si lo que quieres es pasar el audio a inglés, el README indica usar medium o large. Si tu máquina va justa de memoria, small es un buen punto de equilibrio. Para echar cuentas de memoria con más detalle, tienes la guía de cuánta VRAM necesita un modelo de IA.
¿Hace falta tarjeta gráfica?
No es obligatoria, pero cambia la experiencia. Whisper funciona con el procesador (la CPU): la propia herramienta usa la tarjeta gráfica (la GPU) si la encuentra y, si no, tira de CPU. La diferencia es el tiempo. El README de faster-whisper publica una prueba con 13 minutos de audio: el Whisper original con el modelo small en un procesador de sobremesa de 8 hilos tardó 6 minutos y 58 segundos. Con el modelo large-v2, bastante más pesado, en una GPU de 8 GB, el mismo Whisper original tardó 2 minutos y 23 segundos.
Traducido a tu caso: si transcribes unas pocas horas por semana y no tienes prisa, un servidor sin GPU con un modelo pequeño o mediano, trabajando de noche, puede bastarte. Si son muchas horas, si quieres el modelo grande o si necesitas el texto el mismo día, la GPU deja de ser un lujo. En CPU verás un aviso de que no se puede usar FP16 (un modo de cálculo de media precisión que solo aprovechan las tarjetas gráficas); es normal, el programa sigue en FP32 sin que hagas nada.
Whisper o faster-whisper
faster-whisper es una reimplementación de Whisper sobre CTranslate2, un motor pensado para ejecutar este tipo de modelos más deprisa. Usa los mismos modelos, pero su README afirma que es hasta 4 veces más rápido que el original con la misma precisión y gastando menos memoria. Además permite cuantización a 8 bits (int8), que es guardar los números del modelo con menos precisión para que ocupe menos.
Estas son las cifras que publica, transcribiendo los mismos 13 minutos de audio:
| Prueba | Implementación | Tiempo | Memoria |
|---|---|---|---|
| large-v2 en GPU (RTX 3070 Ti 8 GB) | Whisper original, fp16 | 2 min 23 s | 4.708 MB de VRAM |
| large-v2 en GPU | faster-whisper, fp16 | 1 min 03 s | 4.525 MB de VRAM |
| large-v2 en GPU | faster-whisper, int8 | 59 s | 2.926 MB de VRAM |
| small en CPU (8 hilos) | Whisper original, fp32 | 6 min 58 s | 2.335 MB de RAM |
| small en CPU | faster-whisper, int8 | 1 min 42 s | 1.477 MB de RAM |
Son medidas del propio proyecto, en su máquina. El mismo README avisa de que para comparar hay que usar los mismos ajustes, porque el original decodifica por defecto de una forma más simple (beam size 1) y faster-whisper usa beam size 5. Tómalas como orden de magnitud.
Cuándo elegir cada uno:
- Whisper original si quieres lo más sencillo: una orden en la terminal que ya escribe el texto y los subtítulos. Ideal para probar y para volúmenes pequeños.
- faster-whisper si vas a transcribir mucho, si tu máquina no tiene GPU o si la que tienes va justa de memoria. A cambio, se usa desde un pequeño programa en Python y los ficheros de subtítulos los escribes tú (te dejamos el ejemplo).
Un detalle a favor de faster-whisper: no necesita ffmpeg instalado en el sistema, porque decodifica el audio con una librería que ya lo incluye. Para usar la GPU sí pide dos librerías de NVIDIA, cuBLAS y cuDNN 9 para CUDA 12, tal como detalla su README.
Instalar Whisper y transcribir tu primera grabación
Estos pasos son para un servidor Ubuntu o Debian. Instala ffmpeg y el soporte de entornos virtuales de Python, crea un entorno aislado para no mezclar paquetes con el sistema e instala Whisper con el comando que indica el README:
sudo apt update && sudo apt install ffmpeg python3-venv
python3 -m venv /opt/whisper
/opt/whisper/bin/pip install -U openai-whisper
Ahora, la primera transcripción. Le decimos el modelo, el idioma, qué formato queremos y dónde dejarlo:
/opt/whisper/bin/whisper clase-lunes.mp3 --model turbo --language Spanish --output_format all --output_dir transcripcionesLa primera vez descarga el modelo, así que tarda más. Al terminar tendrás en la carpeta transcripciones varios ficheros con el mismo nombre que el audio: clase-lunes.txt, clase-lunes.srt, clase-lunes.vtt y otros en formatos de datos (tsv, json) que sirven si vas a procesar el resultado con un programa. Si solo quieres uno, cambia all por txt, srt o vtt. Todas las opciones están en la ayuda de la herramienta:
/opt/whisper/bin/whisper --helpLo mismo con faster-whisper
Instálalo en su propio entorno virtual:
python3 -m venv /opt/faster-whisper
/opt/faster-whisper/bin/pip install faster-whisper
Este script parte del ejemplo del README de faster-whisper. Transcribe en CPU con int8 y escribe el texto y los subtítulos en SRT:
import sys
from faster_whisper import WhisperModel

def marca(s):
    h, resto = divmod(s, 3600)
    m, seg = divmod(resto, 60)
    return "%02d:%02d:%02d,%03d" % (h, m, int(seg), int((seg % 1) * 1000))

audio = sys.argv[1]
base = audio.rsplit(".", 1)[0]

# En una GPU: device="cuda", compute_type="float16"
model = WhisperModel("small", device="cpu", compute_type="int8")
segments, info = model.transcribe(audio, language="es", beam_size=5)

with open(base + ".txt", "w", encoding="utf-8") as txt, open(base + ".srt", "w", encoding="utf-8") as srt:
    for i, s in enumerate(segments, start=1):
        txt.write(s.text.strip() + "\n")
        srt.write("%d\n%s --> %s\n%s\n\n" % (i, marca(s.start), marca(s.end), s.text.strip()))
Lo ejecutas así:
/opt/faster-whisper/bin/python transcribir.py clase-lunes.mp3Ojo a un detalle que el README subraya: segments es un generador, es decir, la transcripción no empieza hasta que recorres los segmentos. En el script ocurre dentro del bucle, así que no tienes que hacer nada más.
Texto o subtítulos: qué formato te sirve
Cada formato tiene su uso:
- TXT: el texto corrido. Es lo que quieres para leer, buscar o pasar a un resumen.
- SRT: subtítulos con marcas de tiempo. Lo entienden casi todos los editores y reproductores de vídeo.
- VTT (WebVTT): el formato de subtítulos de la web. Si grabas las clases para un aula virtual, es el que te interesa.
En Moodle, por ejemplo, puedes añadir a un vídeo pistas de subtítulos en formato VTT, según la documentación de Moodle sobre vídeo, con la condición de que el fichero esté subido a la plataforma. Si tu academia tiene el campus con nosotros en Moodle gestionado, la transcripción encaja como una pieza más. Revisa siempre el subtítulo antes de publicarlo: un nombre propio mal escrito en pantalla se ve mucho más que en un texto interno.
El flujo real: la carpeta de la semana
Donde Whisper se paga solo es cuando nadie tiene que acordarse de lanzarlo. La idea es sencilla: dejas las grabaciones en una carpeta y a la mañana siguiente tienes el texto en otra.
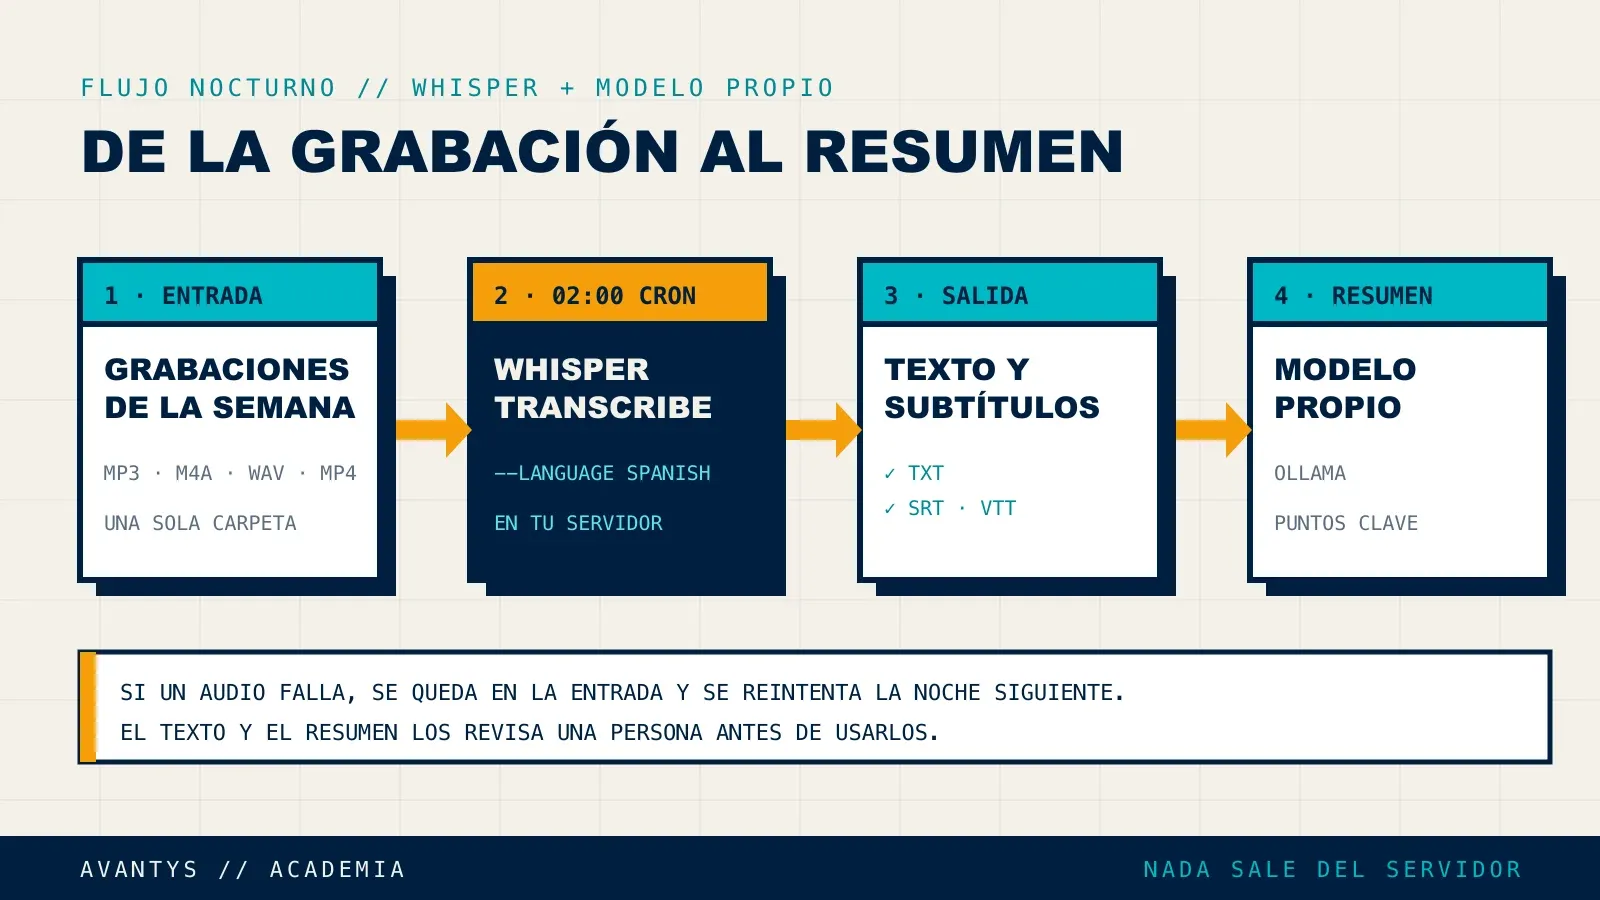
Este script recorre la carpeta de entrada, transcribe cada fichero y lo mueve a otra carpeta cuando ha terminado bien. Si un audio falla, se queda en la entrada y se vuelve a intentar la noche siguiente:
#!/bin/bash
set -u
shopt -s nullglob
ENTRADA=/srv/grabaciones/entrada
SALIDA=/srv/grabaciones/transcripciones
HECHO=/srv/grabaciones/procesadas

for f in "$ENTRADA"/*.{mp3,m4a,wav,mp4}; do
  if /opt/whisper/bin/whisper "$f" --model turbo --language Spanish \
       --output_format all --output_dir "$SALIDA"; then
    mv "$f" "$HECHO"/
  else
    echo "$(date) fallo: $f" >> /var/log/transcribir.log
  fi
done
Lo programas con cron (el programador de tareas de Linux) para que arranque de madrugada. Con flock te aseguras de que, si una noche hay tanto audio que la tanda no ha acabado, la siguiente no arranque encima:
0 2 * * * flock -n /tmp/transcribir.lock /opt/transcribir/transcribir.shUn resumen encima, con tu propio modelo
Una hora de clase son muchas páginas. El paso natural es pedir un resumen con los puntos clave, las dudas o las tareas acordadas. Y si la voz no sale de casa, no tiene sentido mandar el texto fuera. Lo hace un modelo de lenguaje en tu servidor, por ejemplo con Ollama, que te explicamos en la guía de cómo instalar Ollama en tu servidor.
La documentación de Ollama muestra cómo pasarle una petición directamente en la orden. Con eso, un resumen es una línea:
MODELO=gemma4:e2b
ollama run "$MODELO" "Resume en español esta transcripción de clase en 10 puntos y lista las dudas que planteó el alumnado: $(cat transcripciones/clase-lunes.txt)"
Cambia MODELO por el que tengas instalado. Con transcripciones muy largas puede que el texto no quepa entero en lo que el modelo es capaz de leer de una vez; en ese caso resume por partes y luego resume los resúmenes. Y lo mismo que con la transcripción: un resumen automático es un punto de partida. Si va a un acta o a un alumno, lo revisa una persona.
Dónde falla, dicho claro
Whisper es muy bueno, pero tiene límites que conviene conocer antes de prometerle nada a nadie:
- La calidad del audio manda. Un micrófono de solapa o el de la sala bien colocado dan un texto limpio. El micrófono del portátil al fondo del aula, con eco y un proyector zumbando, da un texto con huecos.
- Varias voces a la vez. Cuando dos personas se pisan, el modelo escribe una mezcla o se queda con una. En reuniones con mucho debate, esto se nota.
- No sabe quién habla. Separar las intervenciones por persona se llama diarización, y Whisper no lo hace solo. Hay proyectos que lo añaden encima, como WhisperX, que el README de faster-whisper cita entre sus integraciones, pero es otra pieza que montar y mantener.
- Puede inventar. Como avisa su ficha, en silencios largos o con ruido a veces escribe frases que no se han dicho. El filtro de silencios de faster-whisper (vad_filter=True) ayuda, no lo elimina.
Nada de esto lo hace inútil: es un ayudante que te ahorra la mayor parte del trabajo, no uno que lo hace entero.
La voz también es un dato personal
La voz de una persona y lo que dice en una clase o en una reunión son datos personales. Transcribir en tu servidor evita un problema concreto: no mandas ese audio a un tercero, con sus condiciones, sus copias y sus cambios de política. Pero no te exime del RGPD. Los asistentes tienen que saber que se graba y para qué, la grabación necesita una base legal y tienes que decidir cuánto tiempo guardas el audio y el texto.
La propia ficha de Whisper desaconseja transcribir grabaciones de personas tomadas sin su consentimiento. Y como criterio de referencia, no como obligación legal, la política de uso de IA generativa de la AEPD (versión del 27 de noviembre de 2025) recoge la transcripción de reuniones internas como uno de sus casos de uso. Compara los sistemas de terceros, que señala por el riesgo de revelar información a otros, con los desplegados en infraestructura bajo control de la organización, que da por auditables a cambio de más mantenimiento. Para decidir qué más no debería salir de casa, tienes la guía de qué datos no compartir con una IA.
Lo que esta guía no te cuenta
Instalar Whisper es una tarde. Lo que viene después es lo que decide si en tres meses sigue funcionando:
- Actualizar sin romper. Si tu servidor tiene GPU, una actualización automática del sistema puede cambiar el controlador de NVIDIA a medias. El síntoma típico es que la GPU deja de responder con el error "Failed to initialize NVML: Driver/library version mismatch", y la transcripción se queda en CPU o no arranca. NVIDIA lo explica en su nota de soporte. Hay que decidir qué se actualiza solo y qué no.
- Que la cola no se atasque sin que nadie lo vea. Si un audio corrupto falla cada noche, o el proceso muere a medias, la carpeta de entrada se llena y nadie se entera hasta que alguien pregunta por la transcripción de hace dos semanas. El registro de fallos del script sirve si alguien lo lee o si avisa solo.
- Disco lleno. Una clase en vídeo ocupa mucho. Con varias al día, el disco se llena antes de lo que crees, y cuando se llena falla todo lo demás del servidor.
- Copias. Las transcripciones son trabajo hecho. Si solo viven en ese disco, un fallo se las lleva.
- Borrar lo que ya no hace falta. Una vez transcrito y revisado, ¿necesitas guardar el audio? Si la respuesta es no, bórralo con un plazo fijo. Es menos disco, y menos datos personales que custodiar.
Si prefieres no encargarte tú, lo montamos y lo mantenemos nosotros en un servidor con GPU: Whisper, la carpeta de entrada, el resumen con tu modelo y la vigilancia de todo lo anterior.
Artículos relacionados
- IA privada en tu empresa: qué puedes instalar en tu propio servidor
- Cómo instalar Ollama en un servidor (y cerrarlo para que no lo use cualquiera)
- Cuánta VRAM necesita un modelo de IA: tabla por tamaño
- Qué datos de tu empresa no deberías compartir con una IA
¿Prefieres no encargarte tú?
Montamos tu IA en un servidor con GPU, la dejamos funcionando y la mantenemos nosotros.