Una IA privada en tu empresa es un conjunto de programas que corren en una máquina tuya, de forma que las preguntas, los documentos y las respuestas no salen hacia un servicio de terceros. No es un producto único que se compra y se enchufa. Son varias piezas que encajan: un modelo (el "cerebro", un fichero de varios GB), un programa que lo sirve (Ollama o vLLM), una interfaz de chat para el equipo (Open WebUI) y, si te hace falta, piezas extra para transcribir audio, preguntar a tus documentos, generar imágenes o automatizar tareas. Esta guía es el mapa, y cada sección enlaza a la guía paso a paso de su pieza.
Revisado en septiembre de 2026. Estas herramientas cambian cada pocas semanas: comprueba siempre la documentación oficial que enlazamos antes de copiar un comando.
Por qué montar una IA privada
El motivo casi siempre es el mismo: no quieres que tus datos acaben en el servidor de otro. Cuando pegas un contrato en un chatbot en la nube, ese texto viaja a un proveedor que lo procesa, lo guarda un tiempo y, según el plan y la configuración, puede usarlo para mejorar sus modelos o dejar que su personal lo revise. Con una IA privada el texto se queda en tu máquina. Eso no lo hace seguro por sí solo (una instalación mal cerrada es peor que una API), pero te devuelve el control.
Un buen criterio para decidir qué datos pueden salir y cuáles no es el que usa la propia AEPD para su casa. Su política interna de uso de IA generativa, de noviembre de 2025, pide evaluar si el proveedor entrena con las conversaciones, dónde guarda los datos, durante cuánto tiempo y si su personal puede revisarlos. No es una obligación legal para tu empresa, es la política de un organismo concreto, pero sirve como lista de preguntas.
Antes de montar nada, conviene tener claro qué datos son los delicados. Lo contamos en qué datos de tu empresa no deberías compartir con una IA.
Las piezas, una a una
El modelo: el fichero que piensa
Un modelo de lenguaje (LLM, por sus siglas en inglés) es un fichero de pesos: miles de millones de números que, juntos, predicen la siguiente palabra. Se miden por parámetros: 8B son 8.000 millones, 70B son 70.000 millones. Más parámetros suele significar mejores respuestas y más memoria necesaria. Hay modelos abiertos de varias familias que puedes descargar y usar en tu máquina; cada uno trae su licencia, y conviene leerla antes de usarlo con clientes. Cómo elegir entre familias y qué permite cada licencia lo contamos en qué modelo de IA elegir para tu empresa.
Los modelos se distribuyen también cuantizados: con los números guardados en menos bits (Q4, Q8) para que ocupen menos. Un Q4 ocupa aproximadamente una cuarta parte que el original en FP16 y responde algo peor, aunque para muchas tareas de oficina la diferencia apenas se nota.
El motor: Ollama o vLLM
El modelo solo es un fichero. Hace falta un programa que lo cargue en la tarjeta gráfica y atienda peticiones. Ese es el motor, y hay dos opciones que vas a oír constantemente:
- Ollama: el más sencillo. Se instala con un comando, descarga modelos por nombre y expone una API en el puerto 11434. Pensado para un equipo pequeño o mediano.
- vLLM: más exigente de montar, pensado para servir a muchos usuarios a la vez con buen rendimiento. Arranca con
vllm serve <modelo>y ofrece una API compatible con la de OpenAI en el puerto 8000 por defecto, según su documentación devllm serve.
Hay una tercera, llama.cpp, que está debajo de muchas herramientas y corre incluso sin tarjeta gráfica. La comparativa de las tres, con cuándo usar cada una, está en Ollama, vLLM o llama.cpp: cuál usar.
Para empezar, Ollama. Así se instala Ollama en Linux, según su guía oficial:
curl -fsSL https://ollama.com/install.sh | shEl script instala el programa y lo deja como servicio del sistema. Después descargas un modelo y hablas con él desde la terminal con ollama run seguido del nombre del modelo. Lo detallamos todo, con la configuración que importa, en cómo instalar Ollama en un servidor.
La interfaz: Open WebUI
Tu equipo no va a usar una terminal. Open WebUI es una web con aspecto de chat que se conecta a Ollama (o a cualquier API compatible con OpenAI) y añade lo que una empresa necesita: cuentas de usuario, historial, permisos y subida de documentos. Se instala como contenedor (un paquete aislado con todo lo que el programa necesita para funcionar). Su guía de inicio propone este comando cuando Ollama corre en la misma máquina:
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway \
  -v open-webui:/app/backend/data -e WEBUI_SECRET_KEY=tu-clave-secreta \
  --name open-webui --restart always ghcr.io/open-webui/open-webui:main
Tres cosas de ese comando que conviene entender. -p 3000:8080 publica la web en el puerto 3000 de la máquina. -v open-webui:... guarda usuarios y conversaciones en un volumen, que es lo que tendrás que copiar en las copias de seguridad. Y WEBUI_SECRET_KEY firma las sesiones: la documentación indica generarla con openssl rand -hex 32, no dejar el texto de ejemplo. La guía completa, con usuarios y permisos, está en Open WebUI: un ChatGPT privado para tu empresa.
Preguntar a tus documentos: RAG
RAG (generación aumentada por recuperación) es el nombre técnico de "que la IA responda usando tus documentos". Funciona así: los documentos se trocean, cada trozo se convierte en un vector (una huella numérica de su significado) y, cuando alguien pregunta, el sistema busca los trozos más parecidos y se los pasa al modelo junto con la pregunta. El modelo no "aprende" tus documentos: los lee cada vez.
No necesitas montar esto por separado. Open WebUI ya lo trae: puedes subir ficheros a una conversación o crear bases de conocimiento reutilizables, y su documentación de RAG explica cómo elegir entre búsqueda por fragmentos o meter el documento entero. Lo que sí tienes que decidir tú es quién puede ver cada base de conocimiento, porque un asistente con acceso a las nóminas responderá sobre nóminas a quien le pregunte. Paso a paso, con qué documentos funcionan y cuáles no, en preguntar a tus documentos con IA sin sacarlos de casa.
Transcribir audio: Whisper
Whisper convierte audio en texto: reuniones, llamadas, dictados. Es de OpenAI, pero el código y los pesos se publican con licencia MIT, así que corre entero en tu máquina. Tiene varios tamaños: según su repositorio, el más pequeño pide alrededor de 1 GB de VRAM y el grande unos 10 GB, con una versión "turbo" intermedia de unos 6 GB. Open WebUI incluye la transcripción en su imagen principal, pero si lo que quieres es transcribir lotes de grabaciones, compensa montarlo aparte. Lo explicamos en Whisper: transcribir audio en tu propio servidor.
Generar imágenes
Para imágenes el motor más habitual es ComfyUI, que trabaja con modelos de difusión y se maneja como un diagrama de nodos. Open WebUI puede conectarse a ComfyUI para que el equipo pida imágenes desde el mismo chat. Aviso honesto: es la pieza que más VRAM consume por usuario y la que peor convive con un modelo de texto grande en la misma tarjeta. La instalación, las licencias de los modelos de imagen y cómo compartir la tarjeta están en generar imágenes con IA en tu propio servidor.
Automatizar: n8n
n8n es una herramienta de automatización: "cuando llegue un correo con factura, extrae los datos y apúntalos en la hoja". Se puede instalar en tu propio servidor y tiene un nodo Ollama Chat Model para usar tu modelo local dentro de los flujos. Es la forma de pasar de "tenemos un chat" a "la IA hace trabajo sin que nadie la abra". Un ejemplo completo, clasificando correos con un modelo propio, en n8n con Ollama. Si quieres n8n ya montado, tienes VPS para n8n.
Cómo encajan las piezas
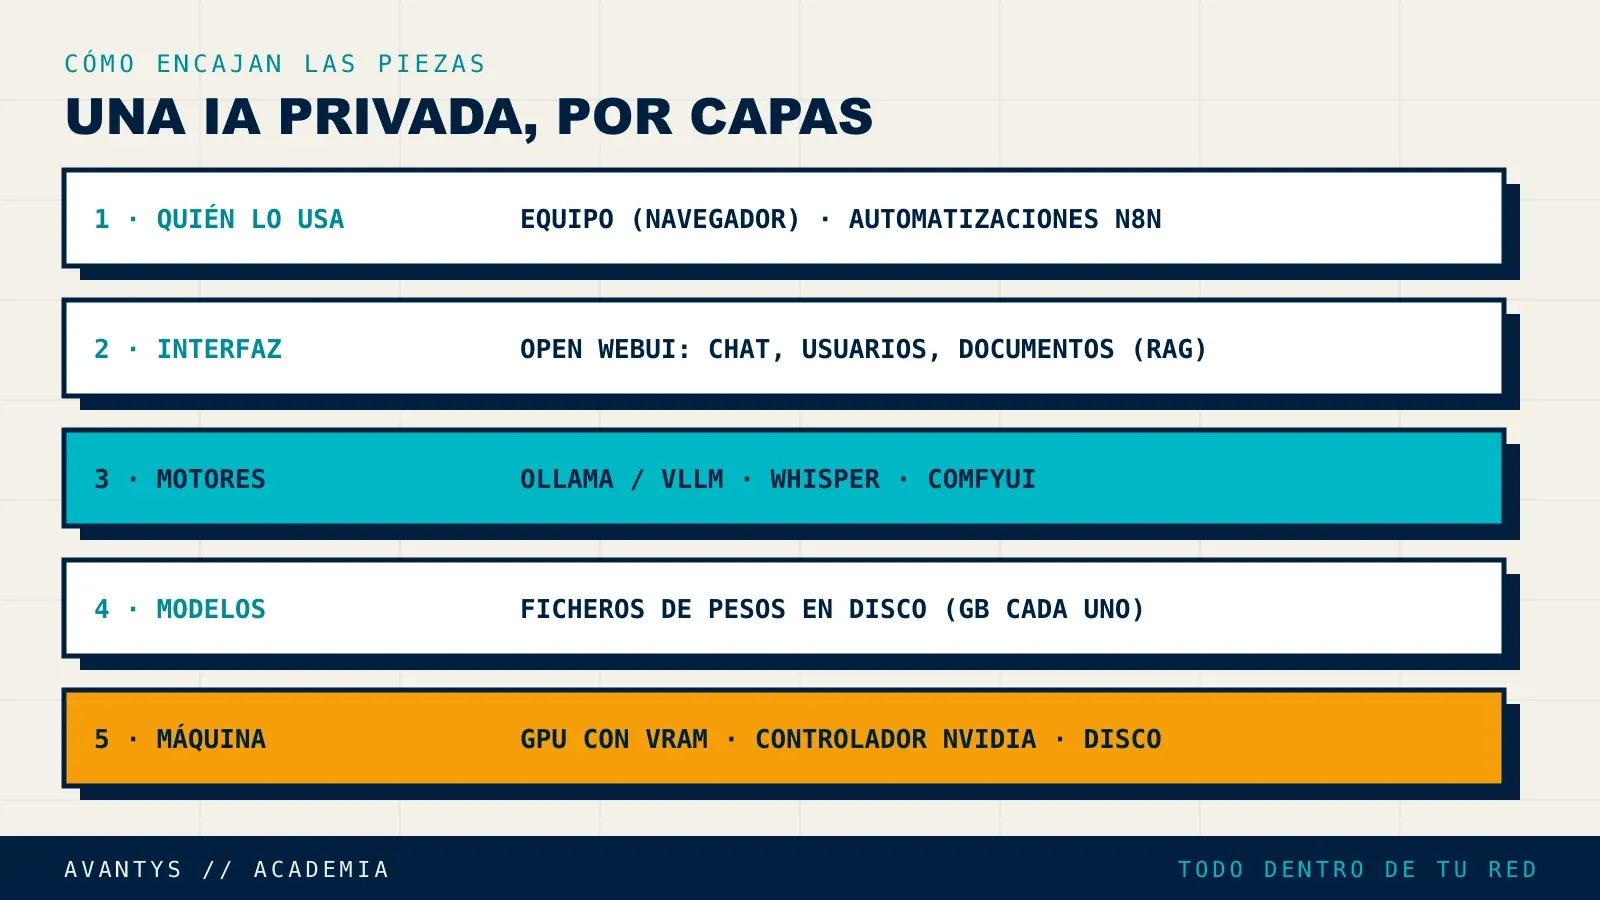
Visto como capas, la instalación típica de una pyme queda así:
| Capa | Pieza | Qué hace | ¿Imprescindible? |
|---|---|---|---|
| Quién lo usa | Navegador del equipo, n8n | Hace las preguntas o lanza las tareas | Sí |
| Interfaz | Open WebUI | Chat, usuarios, permisos, documentos (RAG) | Casi siempre |
| Motor de texto | Ollama (o vLLM) | Carga el modelo y responde | Sí |
| Motor de audio | Whisper | Pasa voz a texto | Si transcribes |
| Motor de imagen | ComfyUI | Genera imágenes | Rara vez al principio |
| Modelos | Ficheros de pesos | El conocimiento en sí | Sí |
| Máquina | GPU con VRAM, disco | Donde corre todo | Sí |
La regla práctica: solo Open WebUI debería ser visible para las personas, y solo dentro de tu red o detrás de una VPN. Ollama, Whisper y ComfyUI escuchan en la propia máquina y reciben peticiones de Open WebUI o de n8n, nunca directamente de internet.
Qué máquina hace falta
Lo que manda es la VRAM, la memoria de la tarjeta gráfica. El modelo tiene que caber entero en ella para ir a una velocidad usable; si no cabe, parte se carga en la memoria normal y las respuestas pasan de segundos a minutos. Como orientación (datos de una guía comunitaria de VRAM, no de un fabricante), solo los pesos ocupan:
| Tamaño del modelo | Q4 | Q8 | FP16 |
|---|---|---|---|
| 8B | 4,6 GB | 8 GB | 16 GB |
| 14B | 8 GB | 14 GB | 28 GB |
| 32B | 18,2 GB | 32 GB | 64 GB |
| 70B | 39,9 GB | 70 GB | 140 GB |
A eso súmale un 15-20 % de margen y la caché de contexto, que crece con lo largo que sea el texto que le pasas. En un 70B, la misma fuente calcula unos 2,6 GB a 8K tokens, unos 10 GB a 32K y unos 41 GB a 128K. Traducido: si quieres que lea documentos largos, la VRAM se va en el contexto tanto como en el modelo. Y Whisper o ComfyUI, si comparten tarjeta, suman lo suyo.
Para la mayoría de pymes, un modelo de 8B a 14B en Q4 u Q8 resuelve redactar, resumir y responder sobre documentos internos. Los 70B se justifican cuando la calidad de razonamiento es crítica. El cálculo detallado, con ejemplos de configuraciones, está en cuánta VRAM necesito para un modelo de IA.
Cuándo compensa y cuándo no
Aquí va la parte que nadie que venda servidores suele decir: si usas la IA poco, una API de pago por uso te sale mejor. Con una API pagas por lo que consumes; con una máquina propia pagas la GPU encendida las 24 horas, la uses o no, más el tiempo de alguien que la mantenga. Si tu equipo hace unas pocas consultas al día y ningún dato es delicado, montar un servidor con GPU es gastar en una máquina que pasará la mayor parte del tiempo parada.
La IA privada compensa cuando se da alguna de estas condiciones:
- Los datos no pueden salir: expedientes de clientes, historiales, contratos, información de personal. Aquí el motivo no es el coste, es que la alternativa no es aceptable.
- El uso es intenso y constante: muchas personas todo el día, o automatizaciones que procesan miles de documentos. El coste fijo se reparte y deja de pesar.
- Necesitas previsibilidad: una cuota fija que no se dispara porque alguien lanzó un proceso mal hecho un viernes.
- Quieres elegir y fijar el modelo: que no cambie de comportamiento porque el proveedor lo actualizó.
Y no compensa cuando necesitas la calidad de los modelos comerciales más grandes (los abiertos que caben en una máquina razonable siguen por detrás en tareas complejas), cuando el uso es esporádico o cuando nadie en la empresa va a ocuparse de mantenerlo. Una solución mixta también es válida: IA privada para lo delicado y API para lo público.
Lo que esta guía no te cuenta
Instalar es la tarde fácil. Lo que viene después es lo que decide si el sistema sigue funcionando dentro de seis meses.
Cerrarlo a internet. Ollama no trae usuarios ni contraseñas: cualquiera que llegue a su puerto puede usarlo. Por defecto escucha solo en la propia máquina (127.0.0.1, puerto 11434, según su FAQ), y el problema aparece cuando alguien lo abre con OLLAMA_HOST=0.0.0.0 para "que funcione desde fuera". No es teórico: en enero de 2026, SentinelOne SentinelLABS y Censys encontraron unas 175.000 máquinas con Ollama abiertas a internet en 130 países, y casi la mitad tenían activada la llamada a herramientas, es decir, podían ejecutar acciones. Meses antes, Cisco había localizado 1.139 solo con Shodan. Comprueba en qué dirección escucha el servicio:
ss -ltnp | grep 11434Si la línea muestra 127.0.0.1:11434, solo la propia máquina puede usarlo. Si muestra 0.0.0.0:11434 o *:11434, está abierto a toda la red y necesitas un cortafuegos delante. Cómo comprobarlo desde fuera y cómo cerrarlo, en orden, en Ollama expuesto a internet. vLLM tiene una opción --api-key, pero su propia documentación advierte de que no protege todas las rutas y que no debes confiar solo en ella.
Actualizar sin romper. El fallo más típico en servidores con GPU: el sistema se actualiza solo, instala un controlador de NVIDIA nuevo, el que está cargado en memoria sigue siendo el viejo y la tarjeta deja de responder. El síntoma es este:
Failed to initialize NVML: Driver/library version mismatchNVIDIA lo documenta en su artículo de soporte: el arreglo habitual es reiniciar para que se cargue el controlador nuevo. La lección es otra: excluye el controlador de las actualizaciones automáticas y actualízalo tú, con reinicio planificado. Tras cualquier actualización, nvidia-smi debe mostrar la tarjeta y ollama ps debe indicar que el modelo cargado usa la GPU y no el procesador.
Vigilar que responde. Una IA privada falla en silencio: la web carga, pero las respuestas no llegan porque el modelo se ha ido a la CPU o el disco está lleno. Necesitas una comprobación periódica que haga una pregunta real y mida el tiempo de respuesta, y una alerta si falla.
Copias. Los modelos no hace falta copiarlos (se vuelven a descargar). Lo que no se recupera es el volumen de Open WebUI: usuarios, conversaciones, bases de conocimiento y ajustes. Ese va en la copia diaria, fuera de la máquina.
Disco lleno de modelos. Cada modelo son varios GB, y probar cinco "a ver cuál va mejor" llena un disco sin avisar. En Linux, Ollama los guarda en /usr/share/ollama/.ollama/models. Revisa de vez en cuando qué hay con ollama list y borra lo que no uses.
Si prefieres no encargarte tú, lo montamos y lo mantenemos nosotros: la máquina, las piezas, el cierre, las actualizaciones y la vigilancia. Tienes los detalles en servidores GPU.
Preguntas frecuentes
¿Una IA privada es tan buena como ChatGPT?
Depende de la tarea. Para redactar, resumir, clasificar y responder sobre tus documentos, un modelo abierto de tamaño medio suele bastar. En razonamiento complejo, los modelos comerciales más grandes siguen por delante. Prueba con tus casos reales antes de decidir.
¿Puedo montarlo sin tarjeta gráfica?
Técnicamente sí: Ollama funciona en CPU. En la práctica, con modelos pequeños y un solo usuario puede servir para probar. Para un equipo, las respuestas serán demasiado lentas.
¿Tener la IA en mi servidor me hace cumplir el RGPD?
No por sí solo. Resuelve dónde están los datos, pero sigues necesitando controlar quién accede, cuánto se conservan las conversaciones y para qué se usan. Un servidor propio mal cerrado expone más que un proveedor bien contratado.
¿Por dónde empiezo?
Por lo mínimo: Ollama, un modelo de 8B y Open WebUI en una máquina con GPU. Úsalo dos semanas con tu equipo, mira qué pide la gente y añade piezas (Whisper, documentos, n8n) según lo que haga falta de verdad. Si quieres que lo veamos juntos, cuéntanoslo.
¿Prefieres no encargarte tú?
Montamos tu IA en un servidor con GPU, la dejamos funcionando y la mantenemos nosotros.