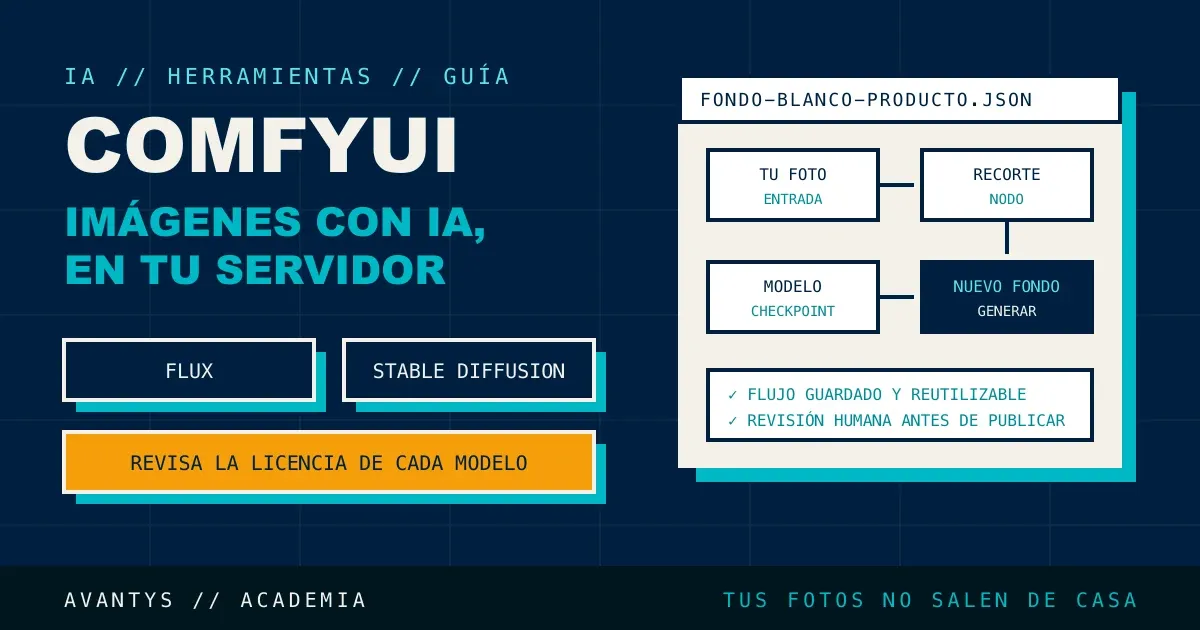
ComfyUI es un programa libre que genera imágenes con modelos de IA de pesos abiertos, y lo puedes instalar en tu propio servidor. Para una tienda online, una agencia o un equipo de marketing significa tres cosas: no pagas por imagen generada, tus fotos de producto no salen a un servicio externo y el proceso que funciona se guarda y se repite igual la semana siguiente. A cambio, la máquina, los modelos y la seguridad son cosa tuya. Aquí vemos los modelos y sus licencias (no todas permiten uso comercial), la instalación en Linux con NVIDIA tal como la documenta el proyecto, los usos reales en una pyme y cómo darle acceso al equipo sin dejarlo abierto a internet. Cada dato lleva enlace a su fuente oficial.
Revisado en septiembre de 2026.
Qué es ComfyUI y por qué funciona con nodos
ComfyUI es una interfaz web para modelos de imagen (y también de vídeo, audio y 3D). Es de código abierto (repositorio oficial). En vez de un cuadro de texto y un botón, ves un lienzo con nodos, cajas unidas con cables: una carga el modelo, otra recibe la descripción (el "prompt"), otra genera y otra guarda. El conjunto se llama flujo de trabajo (en inglés, "workflow").
Al principio asusta un poco, pero cada paso está a la vista y se cambia sin tocar los demás. ¿Quieres quitar el fondo antes de generar uno nuevo? Añades una caja. Hay aplicación de escritorio y versión portátil para Windows; en un servidor Linux toca la instalación manual.
Los modelos: Flux, Stable Diffusion y sus licencias
ComfyUI no trae modelo: lo descargas tú. Según su README, soporta de forma nativa las familias más conocidas de pesos abiertos: Stable Diffusion (1.5, SDXL, 3.5), Flux (Flux.1 y Flux.2) y otras como Qwen Image o Hunyuan Image. "Pesos abiertos" quiere decir que el modelo se descarga y se ejecuta en tu máquina, no que puedas usarlo para lo que quieras. La licencia cambia mucho incluso dentro de la misma familia. Ejemplos de la ficha oficial de cada modelo en Hugging Face:
| Modelo | Licencia | Qué implica para una empresa |
|---|---|---|
| FLUX.1 schnell | Apache 2.0 | La ficha dice que se puede usar con fines personales, científicos y comerciales |
| FLUX.1 dev | FLUX.1 dev Non-Commercial License | Licencia no comercial para el modelo. Según la ficha, las imágenes sí pueden tener uso comercial en sus términos: léela entera |
| Stable Diffusion XL base 1.0 | CreativeML Open RAIL++-M | Licencia abierta con una lista de usos no permitidos que conviene leer |
| Stable Diffusion 3.5 Large | Stability Community License | Uso comercial libre por debajo de un umbral de facturación anual; por encima, licencia de empresa |
La regla práctica: antes de descargar un modelo, abre su ficha y lee la licencia. Las licencias cambian, así que no te fíes de un tutorial (este incluido). Y lo mismo vale para los LoRA (pequeños ajustes que enseñan un estilo o un objeto): cada uno tiene su licencia.
Qué máquina necesitas
Igual que con los modelos de texto, lo que decide la velocidad es la memoria de la tarjeta gráfica, la VRAM. El README de ComfyUI dice que puede ejecutar incluso los modelos abiertos más grandes con tan solo 4 GB de VRAM y 8 GB de RAM "relativamente rápido", gracias a que va pasando partes del modelo entre la memoria normal y la de la tarjeta. Arranca, sí, pero para trabajar a diario, cuanta más VRAM, menos esperas. No damos cifras por modelo porque el proyecto no las publica.
Dos datos oficiales más: el README recomienda Python 3.13 (si algún nodo da problemas, 3.12). Y para tarjetas NVIDIA de la serie 20 en adelante exige PyTorch compilado para CUDA 13.0 o superior, lo que a su vez pide un controlador de NVIDIA reciente. Si quieres entender cómo se reparte la memoria de la tarjeta, lo explicamos en cuánta VRAM necesita cada modelo.
Instalación en un servidor Linux con NVIDIA
Estos pasos siguen la instalación manual del README oficial. Damos por hecho un servidor con tarjeta NVIDIA, el controlador instalado (el comando nvidia-smi debe mostrar la tarjeta) y git y Python disponibles. Añadimos una cosa que el README no pone y que en Ubuntu reciente es obligatoria: un entorno virtual, una carpeta aislada donde Python instala sus librerías sin mezclarlas con las del sistema (documentación de venv).
git clone https://github.com/Comfy-Org/ComfyUI.git
cd ComfyUI
python3 -m venv venv
source venv/bin/activate
pip install torch torchvision torchaudio --extra-index-url https://download.pytorch.org/whl/cu130
pip install -r requirements.txt
La línea de torch es la que da el proyecto para NVIDIA: instala PyTorch (la librería que hace los cálculos en la tarjeta) en su versión para CUDA 13.0. Si al arrancar aparece el error "Torch not compiled with CUDA enabled", el README indica desinstalar torch con pip uninstall torch y repetir esa línea.
Ahora el modelo. Descárgalo desde su ficha oficial (algunos, como FLUX.1 dev, piden aceptar la licencia antes) y colócalo donde toca. Según el README, los modelos completos (ficheros .safetensors o .ckpt) van en models/checkpoints y los VAE en models/vae. Los modelos grandes suelen venir en varios ficheros, y cada uno va a su subcarpeta dentro de models/: sigue las instrucciones de ese modelo.
Y arrancas:
python main.pyPor defecto, ComfyUI escucha solo en 127.0.0.1, puerto 8188. Lo puedes ver en su fichero de opciones. Eso significa que solo la propia máquina llega a él. Para abrirlo desde tu ordenador sin exponer nada, usa un túnel SSH (una conexión cifrada que trae ese puerto hasta tu equipo):
ssh -L 8188:127.0.0.1:8188 usuario@tu-servidorCon el túnel abierto, entra en http://127.0.0.1:8188 en tu navegador. Verás el lienzo con un flujo de ejemplo. Elige tu modelo en el nodo del checkpoint, escribe una descripción y ponlo en cola.
Flujos guardados: el trabajo se hace una vez
Aquí está el valor para una empresa. ComfyUI guarda y carga los flujos como ficheros JSON, y además mete el flujo completo dentro de cada imagen PNG que genera. Si arrastras una de esas imágenes al lienzo, recuperas el flujo exacto que la creó, incluida la semilla (el número que fija el punto de partida aleatorio). Traducido: una imagen buena lleva dentro su receta.
Proponemos separar dos papeles. Quien más sabe prepara y prueba el flujo, y lo guarda con un nombre claro ("fondo-blanco-producto"). El resto del equipo lo abre, cambia la foto de entrada o dos palabras de la descripción, y genera sin entender los cables. Guarda esos JSON con copia de seguridad, como tus plantillas de diseño: son trabajo acumulado.
Para qué sirve de verdad en una pyme
Lo que funciona bien, con revisión, es el trabajo repetitivo alrededor de una foto que ya tienes:
- Fondos de producto. Partes de la foto real del producto, recortada, y generas el fondo: blanco liso para la tienda, o un ambiente (una mesa de madera, una encimera) para redes. El producto sigue siendo tu foto; lo generado es lo que hay alrededor.
- Recortes. Separar el producto del fondo original para reutilizarlo. Es la base de lo demás.
- Variaciones. Varias versiones de una misma pieza para redes, con distinta composición o ambiente, para probar cuál funciona mejor.
- Imágenes de apoyo. Fondos, texturas o ilustraciones genéricas donde nadie espera una foto real.
Lo que no recomendamos es generar el producto en sí. Si el modelo inventa la camiseta, el cliente recibirá otra distinta de la que vio. Y una variación de color solo vale si alguien comprueba que el tono coincide con el real. Ojo: recortes y cambios de fondo suelen pedir nodos añadidos, y más abajo vemos por qué eso pide cuidado.
Lo que hace mal (y por qué hay que revisar siempre)
Los límites deciden si esto te ahorra tiempo o te lo quita:
- Texto dentro de la imagen. Los modelos recientes han mejorado, pero un rótulo, una etiqueta o un precio escrito por la IA sale mal con frecuencia: letras cambiadas o palabras inventadas. El texto ponlo después, con tu herramienta de diseño.
- Manos y detalles pequeños. Dedos de más, asas que no encajan, costuras imposibles. En una imagen de producto, un detalle raro resta confianza.
- Coherencia de marca. Cada generación es distinta. Fijar flujo, semilla y descripción ayuda, y aun así hay que elegir.
- El producto cambia sin avisar. Si el flujo lo toca, puede alterar un logo, un color o una forma.
Por eso la regla es sencilla: ninguna imagen generada se publica sin que alguien del equipo la mire a tamaño completo. La IA acelera la producción; la decisión de publicar sigue siendo del equipo.
Personas reales y marcas ajenas
Que el servidor sea tuyo no cambia las reglas del juego. No generes personas reconocibles (ni famosos, ni clientes, ni empleados sin su consentimiento), ni productos, logotipos o personajes de otras marcas. La imagen de una persona y las marcas registradas están protegidas, lo dibuje quien lo dibuje.
Como criterio de referencia (no es una obligación legal para tu empresa), la AEPD publicó en noviembre de 2025 su política interna de uso de IA generativa. Sus preguntas valen para imágenes: qué entra, dónde se guarda y quién revisa lo que sale. Las fotos de personas que subas son datos personales, y los tratas tú.
Dar acceso al equipo sin dejarlo abierto
Este es el punto más importante de la guía. ComfyUI no trae usuarios ni contraseñas. Su política de seguridad lo dice así: está pensado para ejecutarse en local, escucha en 127.0.0.1 por defecto y asume que cualquiera con acceso a su dirección es de confianza. Si lo abres a la red con la opción --listen, la seguridad de ese despliegue es tuya: cortafuegos, proxy inverso y autenticación. Y los nodos personalizados son código Python arbitrario.
No es teoría. En abril de 2026, investigadores de Censys describieron una campaña que atacaba más de 1.000 ComfyUI expuestos a internet: instalaban nodos maliciosos a través del gestor de nodos y ponían las máquinas a minar criptomonedas.
La forma segura de darle acceso al equipo es dejar ComfyUI en 127.0.0.1 y poner delante un proxy inverso (un programa que recibe las visitas en tu dominio, con certificado HTTPS, y se las pasa por dentro a la aplicación) que pida usuario y contraseña. Con Caddy, siguiendo la documentación de basic_auth, el fichero de configuración queda así:
imagenes.tuempresa.es {
    basic_auth {
        equipo HASH-DE-LA-CONTRASEÑA
    }
    reverse_proxy 127.0.0.1:8188
}
El hash (la contraseña cifrada que se guarda en el fichero, nunca la contraseña en claro) se genera con caddy hash-password. Caddy pide y renueva el certificado HTTPS solo, y la propia documentación avisa de que este tipo de autenticación no es segura sin HTTPS. Es una barrera sencilla, sin cuentas por persona: si las necesitas, ponlo detrás de una VPN o del inicio de sesión de la empresa. Y quien entre podrá instalar nodos, así que dale acceso solo a quien lo necesite.
Pedir imágenes desde el chat con Open WebUI
Si ya tienes un chat privado con Open WebUI, puedes conectarlo a ComfyUI para que el equipo pida imágenes sin ver los nodos. Según la documentación de Open WebUI, los pasos son estos:
- En ComfyUI, activa el "Dev Mode" en los ajustes y exporta tu flujo con "Export (API)". Sale un fichero JSON en un formato especial para la API.
- En Open WebUI, ve a Settings, Admin, Experience, Images. Pon la dirección de ComfyUI y sube ese JSON en el apartado "ComfyUI Workflow".
- Relaciona cada campo (la descripción, el modelo, la semilla, el tamaño) con el número del nodo que lo recibe en tu flujo.
- En el chat, activa "Image" en el menú de integraciones de la caja de texto y pide la imagen.
Un detalle de seguridad. Esa documentación arranca ComfyUI con --listen 0.0.0.0, porque un contenedor de Docker no ve el 127.0.0.1 de la máquina, y eso lo abre a toda la red. Preferimos arrancar Open WebUI con --network=host, como explicamos en su guía: así http://127.0.0.1:8188 funciona sin abrir nada.
Imagen y texto en la misma tarjeta
Es habitual tener en el mismo servidor Ollama con un modelo de texto y ComfyUI con uno de imagen. Funciona, pero comparten la memoria de la tarjeta y no se coordinan: si el texto ocupa casi toda la VRAM, la imagen irá lenta o fallará.
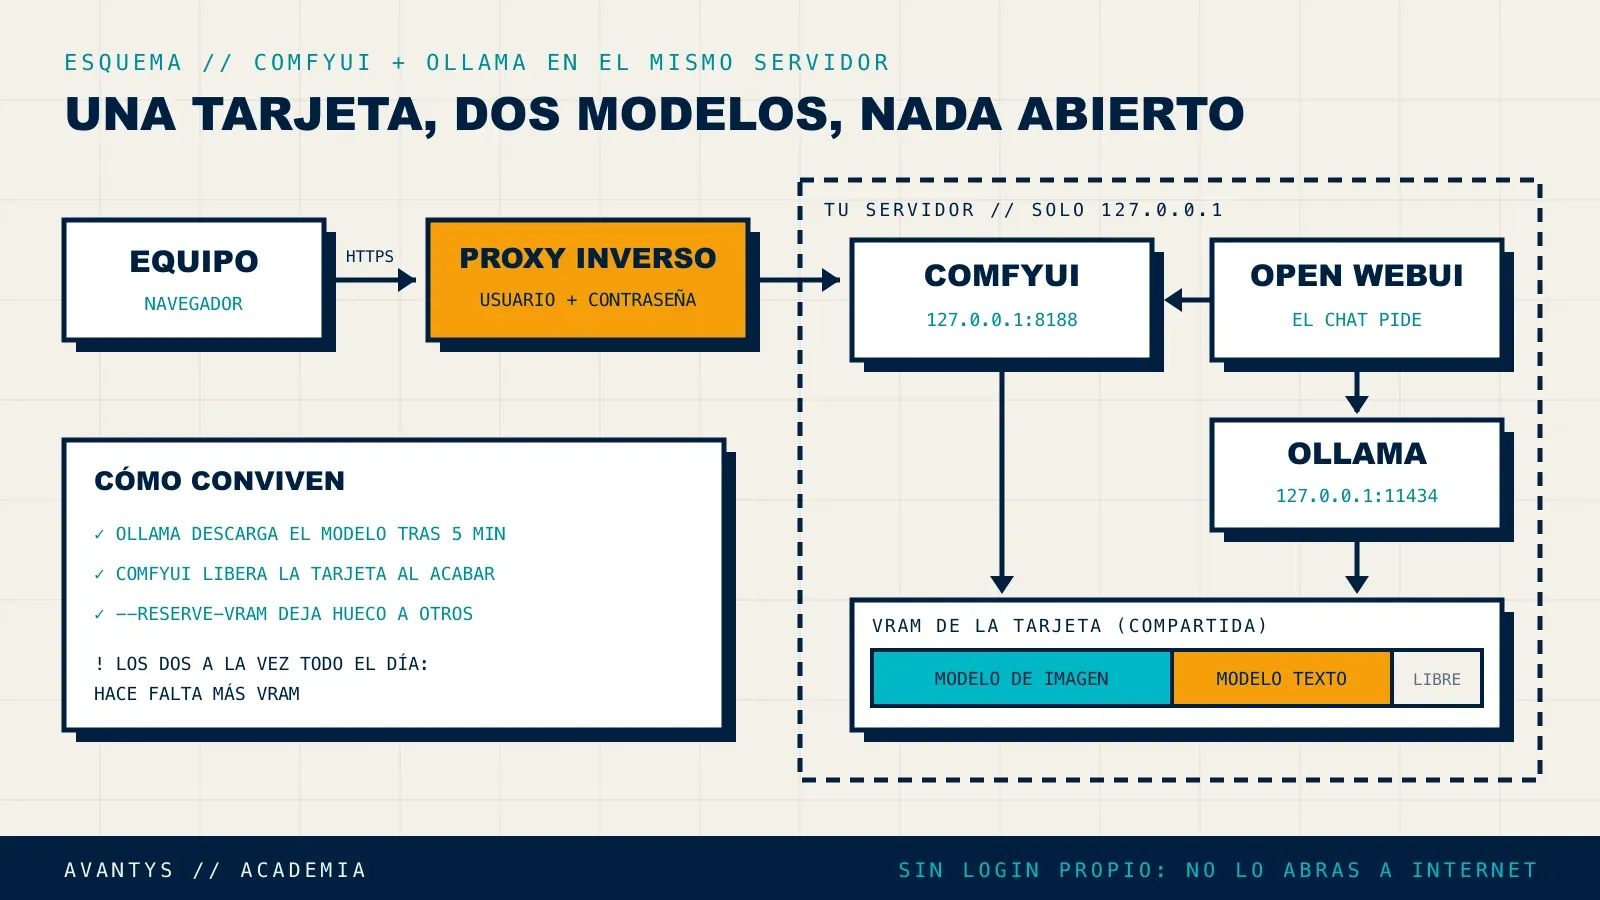
Lo bueno es que los dos sueltan memoria por su cuenta. Según la FAQ de Ollama, un modelo se queda cargado 5 minutos después de usarse y luego se descarga; lo puedes cambiar con la variable OLLAMA_KEEP_ALIVE o descargarlo al momento con ollama stop. Y según sus opciones de arranque, ComfyUI por defecto pasa los modelos a la memoria normal después de usarlos, y tiene --reserve-vram para dejar una cantidad de VRAM libre para otros programas. Con un uso alterno se convive bien. Si el equipo usa las dos cosas a la vez todo el día, hace falta más memoria o una segunda tarjeta.
Lo que esta guía no te cuenta
Instalarlo es la parte corta. Lo que viene después decide si lo sigues usando dentro de seis meses:
- Dejarlo como servicio. Con
python main.pyen una terminal, ComfyUI se para al cerrar la sesión. Hay que convertirlo en un servicio que arranque solo. - Actualizar sin romper. Por un lado, los controladores de NVIDIA: si se actualizan solos, es habitual que la tarjeta deje de responder con el error
Failed to initialize NVML: Driver/library version mismatch. El soporte de NVIDIA explica que suele resolverse reiniciando, pero mientras tanto no generas nada. Por otro, ComfyUI publica versiones con mucha frecuencia, y su README avisa de que las versiones intermedias pueden ser inestables y romper muchos nodos personalizados. Actualiza a versiones estables, con copia hecha, y prueba tus flujos después. - Cerrarlo a internet. ComfyUI en
127.0.0.1, proxy con contraseña delante y cortafuegos revisado. Y comprobarlo desde fuera, no suponerlo. - Vigilar. Que la web cargue no significa que genere: una prueba periódica te avisa antes que el equipo.
- Copias. Los flujos JSON, la configuración y las imágenes que quieras conservar, fuera del servidor y probadas.
- Disco. Cada modelo ocupa gigas y cada imagen generada se queda en la carpeta de salida. El disco se llena en silencio.
Nada de esto es difícil, pero todo es constante. Si prefieres no encargarte tú, lo montamos y lo mantenemos nosotros en un servidor con GPU: ComfyUI, el acceso protegido, las copias y las actualizaciones, con un equipo que responde cuando algo falla.
Preguntas frecuentes
¿Puedo usar comercialmente las imágenes que genero?
Depende del modelo. FLUX.1 schnell (Apache 2.0) lo permite; FLUX.1 dev tiene licencia no comercial para el modelo; Stable Diffusion 3.5 Large, hasta un umbral de facturación. Revisa la licencia de cada modelo en su ficha oficial.
¿ComfyUI tiene usuarios y contraseñas?
No. Su política de seguridad asume que quien llega a su dirección es de confianza. Déjalo en la propia máquina y pon delante un proxy con HTTPS y contraseña, una VPN o un túnel SSH.
¿Sirve para hacer las fotos de mi producto desde cero?
No lo recomendamos. Usa tu foto real del producto y genera lo de alrededor: fondo, ambiente, variaciones de composición. Un producto inventado puede no parecerse al que recibe el cliente.
Artículos relacionados
- Cuánta VRAM necesitas para un modelo de IA
- Open WebUI: cómo montar un ChatGPT privado para tu equipo
- Cómo instalar Ollama en un servidor y cerrarlo a internet
¿Prefieres no encargarte tú?
Montamos tu IA en un servidor con GPU, la dejamos funcionando y la mantenemos nosotros.