IA privada
Explora 6 artículos sobre este tema.
Error cargando el buscador
Por favor, asegúrate de haber ejecutado el build del proyecto.
Artículos con esta etiqueta
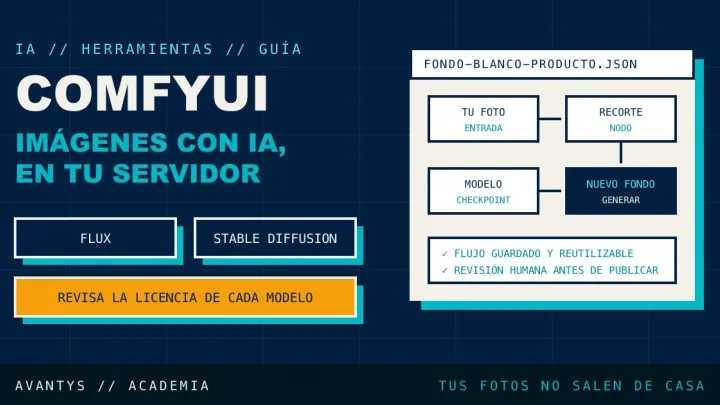
Generar imágenes con IA en tu propio servidor (ComfyUI)
Instala ComfyUI en tu servidor con GPU: modelos Flux y Stable Diffusion, sus licencias, flujos reutilizables para producto y cómo darle acceso al equipo.
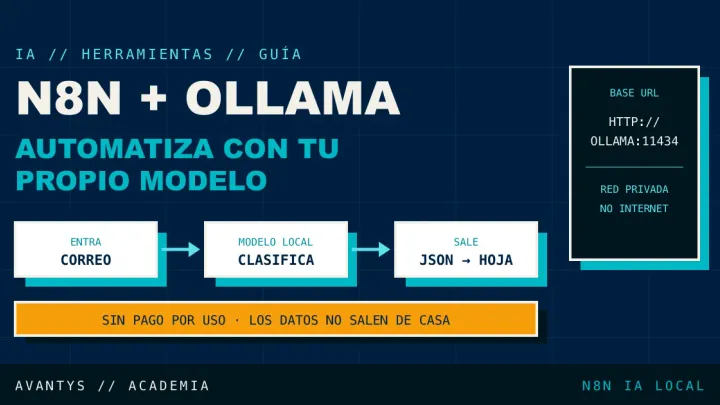
n8n con Ollama: automatiza con IA sin pagar por uso
Conecta n8n con Ollama para clasificar correos o extraer datos con tu propio modelo: nodos, URL correcta en Docker, salida en JSON, reintentos y límites.
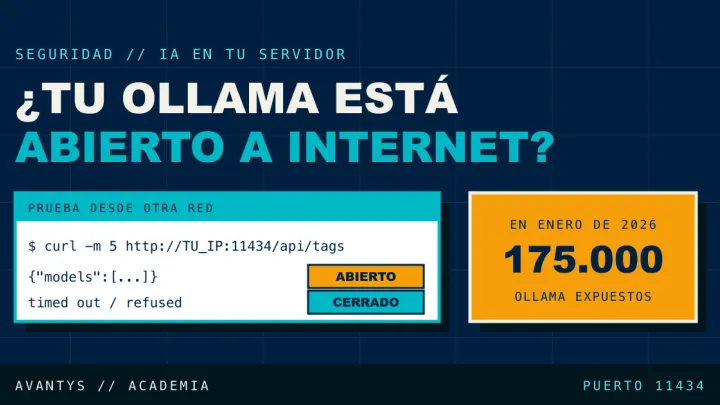
Ollama expuesto a internet: el riesgo y cómo cerrarlo
Cómo saber si tu Ollama está abierto a internet en el puerto 11434 y cómo cerrarlo paso a paso: solo local, cortafuegos, Docker, VPN y proxy con contraseña.
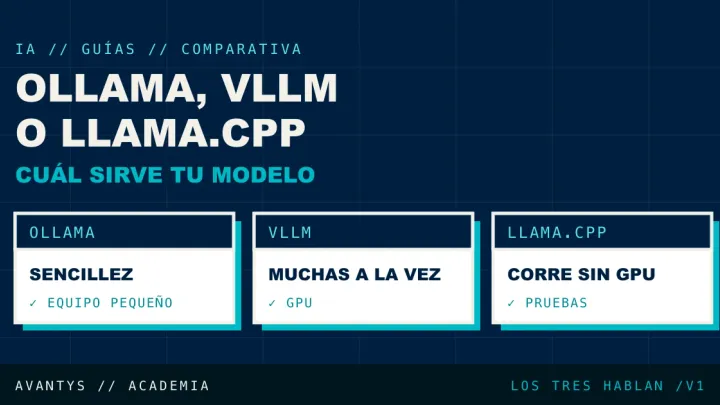
Ollama, vLLM o llama.cpp: cuál usar para servir tu modelo
Ollama vs vLLM vs llama.cpp: qué hace cada uno, cuándo conviene en una pyme, cómo se arranca y qué protege su clave. Comparativa con la documentación oficial.
Qué modelo de IA de código abierto elegir para tu empresa
Cómo elegir un modelo de IA abierto para tu empresa: Llama, Qwen, Mistral, Gemma, DeepSeek o Phi según tarea, idioma, memoria y, sobre todo, su licencia.
Cómo instalar Ollama en un servidor y cerrarlo a internet
Guía para instalar Ollama en un servidor Linux con GPU: comprobar la VRAM, probar un modelo, usar su API y cerrarlo bien, porque no trae contraseña de serie.