Ollama, vLLM y llama.cpp hacen lo mismo en lo básico: cargan un modelo de lenguaje en tu servidor y lo sirven por una API, casi siempre compatible con la de OpenAI. Donde se separan es en para quién están pensados. Ollama prioriza la sencillez: instalas, descargas un modelo y funciona. vLLM prioriza el rendimiento cuando llegan muchas peticiones a la vez, y está hecho para tarjetas gráficas. llama.cpp es el motor ligero en C/C++ que corre incluso sin GPU y que sirve con su programa llama-server. En una pyme la elección suele ser corta: un equipo pequeño chateando, Ollama; una aplicación con cientos de peticiones, vLLM; una máquina sin GPU o unas pruebas, llama.cpp. Aquí va cada uno según su documentación oficial, cómo se arranca y qué protege (y qué no) su clave.
Revisado en septiembre de 2026. Estos tres proyectos cambian cada pocas semanas: cada dato lleva enlace a su fuente, y si algo no cuadra, manda la fuente.
Qué es un servidor de modelos y por qué hay varios
Un modelo de lenguaje, por sí solo, es un fichero de varios gigas: los "pesos". No responde a nada. Para que conteste hace falta un programa que lo cargue en memoria (idealmente en la memoria de la tarjeta gráfica, la VRAM), que reciba preguntas, genere la respuesta palabra a palabra y la devuelva. Ese programa es el servidor de modelos, y lo que ofrece hacia fuera es una API: una puerta por la que otros programas (un chat como Open WebUI, un flujo de automatización, tu propia aplicación) le mandan texto y reciben texto. Hay varios porque el problema tiene dos extremos. Si lo usan cinco personas de vez en cuando, importa que sea fácil de instalar y que no se coma la máquina cuando nadie pregunta. Si lo usa una aplicación que lanza cientos de peticiones a la vez, importa exprimir la GPU sin que la cola se dispare. Cada uno de los tres se ha quedado con una parte de ese terreno.
Ninguno de los tres es un chat: la ventana con usuarios la pone otra pieza, como Open WebUI.
Ollama: el más sencillo
Ollama es el que menos te pide. Se instala con un comando, descarga modelos de su propio catálogo con ollama pull y los carga y descarga de memoria solo, según se usan: por defecto, un modelo que nadie usa en cinco minutos se libera. Esa gestión de modelos es su gran ventaja para un equipo pequeño, porque no tienes que pensar en rutas, ficheros ni formatos. Por dentro trabaja sobre todo con GGUF, el formato de modelo comprimido que popularizó llama.cpp, y según su guía de importación también acepta pesos en formato Safetensors. Durante años se apoyó en llama.cpp; hoy tiene su propio motor sobre la biblioteca GGML, la misma base de llama.cpp.
Escucha en el puerto 11434 y ofrece, además de su API propia, una API compatible con OpenAI en /v1. Funciona con GPU y sin ella.
Su límite está en la concurrencia. Según su FAQ, por defecto cada modelo atiende una petición a la vez (OLLAMA_NUM_PARALLEL, valor 1) y deja el resto en cola, hasta 512. Puedes subirlo, pero la misma FAQ avisa de que cada petición en paralelo multiplica la memoria del contexto: 2.000 tokens con 4 peticiones a la vez equivalen a un contexto de 8.000. Para un equipo que pregunta de vez en cuando basta; con tráfico constante se queda corto antes que los otros dos.
La instalación paso a paso, con la comprobación de que usa la GPU, la tienes en cómo instalar Ollama en un servidor. Aquí no la repetimos.
vLLM: el de muchas peticiones a la vez
vLLM es un servidor pensado para rendimiento. Su documentación destaca dos técnicas. La primera es PagedAttention: mientras el modelo contesta, guarda en la VRAM una memoria de trabajo de la conversación (la "caché KV"). vLLM la parte en bloques en lugar de reservar un trozo grande y continuo por petición, así desperdicia menos memoria y le caben más conversaciones a la vez. La segunda es el batching continuo: en vez de esperar a juntar un grupo de peticiones y procesarlas de golpe, va metiendo las nuevas en cuanto hay hueco. La cifra de referencia es la del artículo original de sus autores: entre 2 y 4 veces más rendimiento que otros sistemas de 2023 con la misma latencia. Es una medida de sus autores, con los modelos y tarjetas de entonces, no una promesa para tu máquina.
El precio de ese rendimiento es la exigencia. vLLM se instala como paquete de Python, pide Linux y, en NVIDIA, una tarjeta con capacidad de cómputo 7.5 o superior. Existe soporte para CPU, pero su terreno es la GPU. Trabaja con los modelos de Hugging Face en su formato original y con varias compresiones (GPTQ, AWQ, FP8 y otras). GGUF lo admite, pero su propia página de GGUF lo califica de "muy experimental". Y un detalle que sorprende la primera vez: por defecto reserva el 92 % de la VRAM de la tarjeta (--gpu-memory-utilization, según su referencia de vllm serve). Es para tener sitio para esa caché, y significa que esa tarjeta no la compartes con otra cosa.
llama.cpp: el motor que corre casi en cualquier sitio
llama.cpp se describe como inferencia de modelos en C/C++, con el objetivo de funcionar con una configuración mínima en mucho hardware distinto. Corre en procesador (aprovechando sus instrucciones AVX), en NVIDIA con CUDA, en AMD, en Intel, en Mac y con Vulkan. Es de donde sale el formato GGUF, y es el motor de muchas herramientas de escritorio y servidor, aunque no siempre lo veas. Para servir un modelo trae llama-server, un servidor HTTP ligero que, según su documentación, ofrece rutas compatibles con OpenAI, atención a varios usuarios con "slots" en paralelo, batching continuo activado por defecto y una pequeña interfaz web. Escucha por defecto en 127.0.0.1:8080.
Es la opción cuando no hay GPU, cuando la máquina es modesta o cuando quieres controlar cada parámetro. A cambio, te da más trabajo manual: tú eliges el fichero GGUF, su compresión y el tamaño del contexto, sin un catálogo que lo gestione por ti.
La comparativa, celda a celda
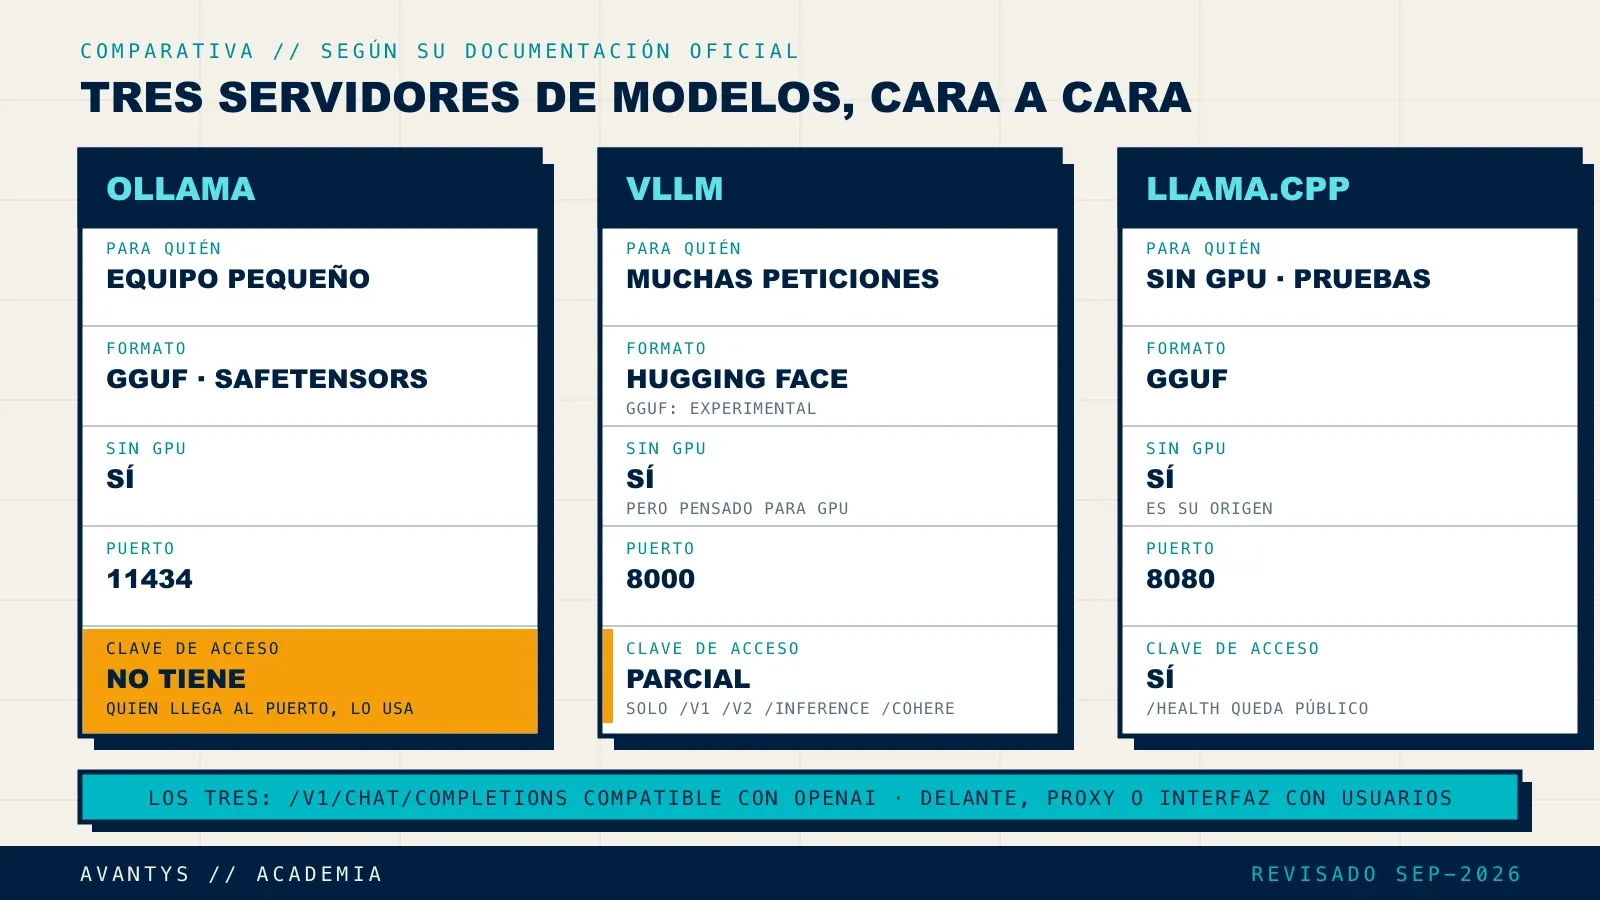
Cada celda sale de la documentación enlazada arriba. Donde no hay cifra oficial, la comparación es cualitativa.
| Ollama | vLLM | llama.cpp (llama-server) | |
|---|---|---|---|
| Facilidad | La más sencilla: un comando instala y un catálogo gestiona los modelos | La más exigente: Python, Linux y GPU compatible | Intermedia: binario o compilación, y tú eliges los ficheros |
| Varios usuarios a la vez | 1 petición por modelo por defecto, ampliable | Su punto fuerte: PagedAttention y batching continuo | Slots en paralelo y batching continuo por defecto |
| Uso de memoria | Carga y descarga modelos según se usan; el paralelo multiplica el contexto | Reserva el 92 % de la VRAM por defecto | Lo que pides: modelo, contexto y slots |
| Formatos de modelo | GGUF y Safetensors | Formato de Hugging Face y compresiones como GPTQ, AWQ o FP8; GGUF experimental | GGUF |
| Funciona sin GPU | Sí | Sí, pero está pensado para GPU | Sí, es su origen |
| API compatible con OpenAI | Sí, en /v1 | Sí, en /v1 | Sí, en /v1 |
| Puerto por defecto | 11434 | 8000 | 8080 |
| Clave de acceso incluida | No: ignora la clave | Sí (--api-key), solo en parte de las rutas | Sí (--api-key), /health queda público |
Cuál elegir: tres casos de pyme
Cinco personas en un chat. Una asesoría quiere que su equipo pregunte a un modelo privado para redactar, resumir y revisar textos. Las preguntas llegan de una en una, con minutos entre ellas. Aquí gana Ollama con Open WebUI delante: se monta en una tarde, se cambia de modelo sin tocar nada y, cuando nadie pregunta, libera la memoria. Si coinciden varias preguntas, esperan unos segundos en la cola.
Una aplicación con cientos de peticiones. Una tienda online clasifica cada correo de cliente, o una aplicación interna resume cada documento que entra. Aquí las peticiones llegan solas, a la vez y todo el día. Ahí vLLM justifica su complejidad: aprovecha la tarjeta mucho mejor con muchas conversaciones simultáneas. A cambio necesitas una GPU compatible y alguien que sepa mantener un entorno de Python con CUDA.
Una máquina sin GPU, o unas pruebas. Quieres comprobar si un modelo pequeño sirve para tu caso antes de pagar una tarjeta, o tienes un servidor sin GPU con memoria de sobra. llama.cpp corre en procesador, con modelos comprimidos en GGUF. Será lento para uso diario, pero sirve para validar una idea o para tareas sin prisa, como procesar documentos por la noche.
En los tres casos, lo que decide el tamaño del modelo que puedes usar no es el programa, sino la memoria. La cuenta la tienes en cuánta VRAM necesito para un modelo de IA.
Cómo se arranca cada uno
Los comandos mínimos, tal como los documenta cada proyecto. En los tres, el servidor escucha solo dentro de la máquina (la sección siguiente explica por qué).
Ollama. Tras instalarlo con la guía oficial, el servicio ya está escuchando en 127.0.0.1:11434. Descargas y pruebas un modelo:
ollama pull gemma4:e2b
ollama run gemma4:e2b
vLLM. La guía de inicio lo instala en un entorno de Python con uv y lo arranca con vllm serve. La clave se puede pasar con --api-key o con la variable VLLM_API_KEY. La generamos al azar y le decimos que escuche solo en local:
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
export VLLM_API_KEY="$(openssl rand -hex 32)"
vllm serve Qwen/Qwen2.5-1.5B-Instruct --host 127.0.0.1
La primera vez descarga el modelo de Hugging Face. Al terminar, la API queda en el puerto 8000.
llama.cpp. Se instala con los binarios de su página de versiones, con Docker o compilándolo. Su servidor descarga un GGUF de Hugging Face con -hf, y admite una lista de claves en un fichero, una por línea:
llama-server -hf ggml-org/Qwen3.5-0.8B-GGUF --host 127.0.0.1 --port 8080 --api-key-file /etc/llama/claves.txtSi ya tienes el fichero, se carga con -m ruta/al/modelo.gguf en lugar de -hf. Ese fichero de claves tiene que poder leerlo solo el usuario que ejecuta el servidor.
Ninguno trae usuarios de serie
Ninguno de los tres tiene cuentas de usuario: como mucho, una clave compartida. Y lo que protege esa clave cambia de uno a otro.
- Ollama no tiene clave. Su página de autenticación dice que la API local no pide autenticación, y la de compatibilidad con OpenAI, que la clave que exigen las librerías se ignora. Quien llega al puerto 11434, lo usa. Por eso escucha por defecto solo en
127.0.0.1. No es teoría: en enero de 2026, SentinelOne y Censys encontraron unas 175.000 máquinas con Ollama abiertas a internet en 130 países. - vLLM tiene
--api-key, pero no cubre todo. Su guía de seguridad explica que la clave solo protege las rutas que empiezan por/v1,/v2,/inferencey/cohere. Otras quedan abiertas aunque pongas clave, entre ellas/invocations, que da acceso al mismo modelo, y rutas de control como/pauseo/abort_requests. La propia documentación pide no fiarse solo de la clave y poner delante un proxy que deje pasar únicamente las rutas que necesitas. - llama-server tiene
--api-keyy--api-key-file. Admite varias claves, y su documentación indica que/healthqueda público, sin comprobar la clave. Para un servidor accesible desde fuera, recomienda clave más proxy inverso.
Además, una clave compartida no dice quién preguntó qué, ni permite quitar el acceso a una persona sin cambiársela a todos. Por eso, en una empresa, delante del servidor de modelos se pone una de dos cosas. Una interfaz con usuarios, como Open WebUI, que habla con el modelo por dentro y es lo único que sale a la red. O un proxy inverso (nginx, por ejemplo) con HTTPS, que pide credenciales y solo deja pasar las rutas que usas. El servidor de modelos, mientras tanto, sigue escuchando en 127.0.0.1.
Cambiar de uno a otro sin tocar tus aplicaciones
Los tres ofrecen la ruta /v1/chat/completions con el mismo formato que la API de OpenAI. Si tus aplicaciones hablan ese idioma, pasar de Ollama a vLLM (porque el uso ha crecido) o de llama.cpp a Ollama (porque ya tienes GPU) se reduce a cambiar tres datos en su configuración: la dirección, la clave y el nombre del modelo. Una prueba que vale para los tres, cambiando esos tres datos:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $VLLM_API_KEY" \
  -d '{"model": "Qwen/Qwen2.5-1.5B-Instruct", "messages": [{"role": "user", "content": "Di hola en una frase"}]}'
Ojo con el nombre del modelo, que es lo que más falla en una migración. En Ollama es el de su catálogo (gemma4:e2b). En vLLM, el identificador de Hugging Face. En llama-server, por defecto, la ruta del fichero, aunque puedes darle otro con --alias. Y cada uno tiene funciones propias fuera de /v1 (la API nativa de Ollama, por ejemplo): si tu aplicación usa alguna, el cambio ya no es tan limpio. Por eso recomendamos que todo lo que construyas hable con la parte compatible con OpenAI desde el primer día.
Preguntas frecuentes
¿Ollama es más lento que vLLM?
Depende de cuántas peticiones lleguen a la vez. La ventaja de vLLM está en atender muchas simultáneas, que es para lo que está diseñado; con una persona preguntando de vez en cuando, esa ventaja apenas entra en juego. No hay una cifra oficial que compare los dos en tu máquina: si el dato te importa, mide con tu modelo y tu tráfico real.
¿Puedo usar vLLM sin tarjeta gráfica?
Su documentación incluye soporte para procesadores x86 y ARM, pero su diseño está pensado para GPU. Para una máquina sin tarjeta, llama.cpp u Ollama son la opción más habitual.
¿Puedo tener los tres en el mismo servidor?
Sí, cada uno escucha en su puerto (11434, 8000 y 8080). Lo que no puedes es darles a los tres toda la VRAM: vLLM reserva por defecto el 92 % de la tarjeta, así que si convive con otro hay que bajarle ese porcentaje.
Lo que esta guía no te cuenta
Elegir y arrancar es la primera tarde. Mantenerlo funcionando es cada semana:
- Actualizar sin romper. Los tres dependen de los controladores de NVIDIA y de una versión compatible de CUDA: vLLM se distribuye compilado para versiones concretas, llama.cpp tiene binarios por versión de CUDA y Ollama pide un controlador mínimo. Cuando el sistema actualiza solo los controladores, el cargado y el instalado dejan de coincidir hasta que reinicias, y
nvidia-smiresponde "Failed to initialize NVML: Driver/library version mismatch". NVIDIA lo documenta. El servidor puede seguir en marcha, pero en procesador o sin responder. - Cerrarlo a internet. Un
--host 0.0.0.0para una prueba o un contenedor con el puerto publicado, y la API queda abierta. Se comprueba desde fuera, no se supone. - Vigilar que responde. Un proceso activo no es un modelo que contesta. La prueba útil es una pregunta real cada pocos minutos.
- Copias. Los modelos se vuelven a descargar, pero tu configuración, tus claves y los datos de la interfaz de chat no.
- Disco. Cada modelo son gigas, y en vLLM y llama.cpp la caché de Hugging Face crece sola con cada prueba.
Todo esto se puede hacer con tiempo y cuidado. Si prefieres no encargarte tú, elegimos, lo montamos y lo mantenemos nosotros en un servidor con GPU: el servidor de modelos que encaje con tu uso, cerrado a internet, vigilado y actualizado. Hablas con personas, no con un panel.
Artículos relacionados
- Cómo instalar Ollama en un servidor y cerrarlo a internet
- Cuánta VRAM necesito para un modelo de IA
- Open WebUI: un ChatGPT privado para tu equipo
¿Prefieres no encargarte tú?
Montamos tu IA en un servidor con GPU, la dejamos funcionando y la mantenemos nosotros.