n8n puede usar un modelo de IA que corre en tu propio servidor, con Ollama, en lugar de una API de pago por uso. Así tus flujos clasifican correos, resumen pedidos o preparan borradores de respuesta sin que el texto de tus clientes salga de tu máquina y sin una factura que crece con cada petición. Conectarlos es un nodo y una dirección. Lo difícil es acertar con esa dirección (en Docker, "localhost" engaña) y que el modelo conteste siempre con el mismo formato. En esta guía montamos un ejemplo completo: llega un correo, el modelo lo clasifica, saca los datos útiles y los apunta en una hoja. Cada dato lleva enlace a la documentación oficial de n8n o de Ollama.
Revisado en septiembre de 2026.
Qué es n8n y qué le aporta la IA
n8n es una herramienta de automatización: une programas con flujos del tipo "cuando pase esto, haz aquello". Cuando llega un correo, cuando alguien rellena un formulario o cada mañana a las ocho, n8n lanza una cadena de pasos (los nodos) que leen, transforman y guardan datos. Se puede instalar en tu propio servidor, y si lo quieres ya montado tienes VPS para n8n.
Sin IA, n8n maneja bien datos ordenados, pero no sabe leer texto libre. "Hola, os escribo por lo del pedido de la semana pasada, que al final necesitamos 20 cajas más para el viernes" no encaja en ninguna regla. Ahí entra el modelo de lenguaje: lee ese texto y devuelve algo ordenado (categoría: pedido; cantidad: 20; fecha: viernes) que el resto del flujo ya sabe manejar.
Si no tienes claro qué automatizar primero, empieza por qué tareas automatizar con IA. Esta guía da por hecho que ya tienes una candidata.
Los nodos de n8n que hablan con Ollama
n8n trae nodos oficiales para Ollama. Los dos que importan aquí son subnodos: no hacen nada solos, se enganchan a un nodo principal (el que decide qué se le pide al modelo). La documentación los separa así:
| Nodo | Qué es | Cuándo usarlo |
|---|---|---|
| Ollama Chat Model | Modelo en modo conversación | Lo normal: clasificar, extraer, redactar, agentes |
| Ollama Model | Modelo en modo "completar texto" | Casos concretos que piden ese formato |
| Text Classifier | Nodo principal que reparte en categorías | Separar correos, tickets o mensajes |
| Information Extractor | Nodo principal que saca datos con un esquema | Convertir texto libre en campos |
Los dos subnodos de Ollama usan la misma credencial, que tiene solo dos campos según la documentación de la credencial de Ollama: la Base URL, que por defecto es http://localhost:11434, y una API Key opcional, que solo hace falta si Ollama está detrás de un intermediario que pide contraseña (por ejemplo, Open WebUI). Con una instalación normal de Ollama se deja vacía.
El modelo se elige en un desplegable que n8n rellena preguntándole a Ollama qué modelos tiene descargados (lo hace llamando a /api/tags, según el código fuente del nodo).
Conectar n8n con Ollama: la dirección correcta
Aquí se atasca casi todo el mundo, y la página de problemas comunes de n8n lo explica bien: en Docker, cada contenedor tiene su propio localhost. Si n8n está en un contenedor y escribes http://localhost:11434, n8n se busca a sí mismo, no a Ollama, y la conexión falla. La dirección buena depende de dónde está cada pieza:
| Dónde está cada uno | Base URL que indica n8n |
|---|---|
| Los dos instalados directamente en el servidor, sin Docker | http://localhost:11434 |
| Los dos en contenedores separados, en la misma red de Docker | http://nombre-del-contenedor:11434 |
| Solo n8n en Docker, Ollama en el servidor | http://host.docker.internal:11434 (en Linux, arrancando n8n con --add-host host.docker.internal:host-gateway) |
Error ECONNREFUSED ::1:11434 | Cambia localhost por http://127.0.0.1:11434 |
El último pasa cuando el servidor tiene IPv6 y Ollama escucha solo en IPv4: 127.0.0.1 fuerza el bueno.
Cuidado con la solución fácil
Para el caso "solo n8n en Docker", la documentación de n8n indica que Ollama escuche en 0.0.0.0 (todas las direcciones del servidor). Funciona, pero si ese servidor tiene IP pública y nada que filtre el puerto 11434, acabas de publicar en internet una API sin contraseña. No es un riesgo teórico: en enero de 2026, SentinelOne SentinelLABS y Censys encontraron unas 175.000 máquinas con Ollama abierto a internet en 130 países. Y si Ollama va en Docker publicado con -p 11434:11434, Docker avisa de que esos puertos se saltan las reglas de ufw.
La regla es simple: n8n y Ollama en la misma máquina o en la misma red privada, y Ollama sin puerto hacia fuera. Lo más limpio es ponerlos juntos en Docker Compose, que crea una red interna donde cada servicio se alcanza por su nombre (documentación de Docker):
services:
  ollama:
    image: ollama/ollama
    volumes:
      - ollama:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  n8n:
    image: n8nio/n8n
    ports:
      - "127.0.0.1:5678:5678"
    volumes:
      - n8n_data:/home/node/.n8n

volumes:
  ollama:
  n8n_data:
Fíjate en tres cosas. El servicio ollama no tiene ports: nadie de fuera llega a él, pero n8n sí, por la red interna, con la Base URL http://ollama:11434. La reserva de GPU sigue la sintaxis de la guía de GPU de Docker Compose. Y n8n se publica solo en 127.0.0.1, para poner delante un proxy con HTTPS, como explicamos en la guía de Open WebUI. La carpeta /home/node/.n8n es la que indica la instalación con Docker de n8n. Con los contenedores en marcha, descarga un modelo dentro del de Ollama:
docker compose exec ollama ollama pull gemma4:e2bSi prefieres Ollama instalado directamente en el servidor, sin contenedor, lo tienes paso a paso en cómo instalar Ollama en un servidor.
Ejemplo completo: clasificar correos y apuntar los datos en una hoja
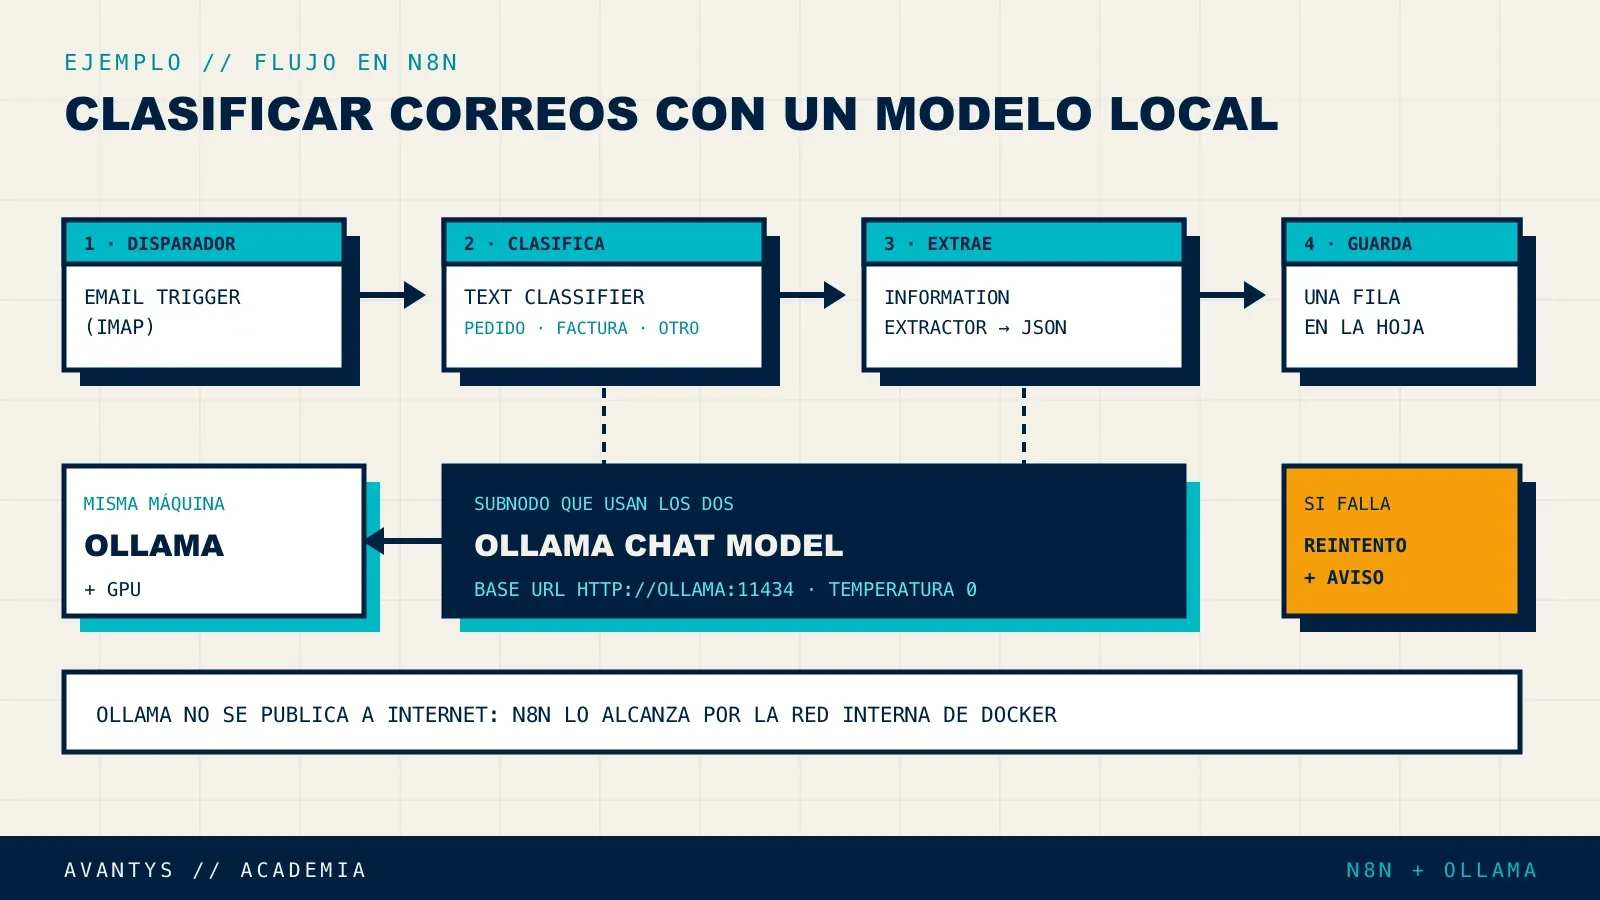
El caso: una bandeja de pedidos donde llegan también facturas, dudas y publicidad. Queremos que los pedidos acaben como filas en una hoja, con cliente, número y fecha, y que lo demás se aparte. Estos son los pasos en n8n:
- Disparador. Añade el nodo Email Trigger (IMAP), con la credencial de tu buzón y la carpeta que quieres vigilar. El texto del correo llega en el campo
textPlain(compruébalo en la vista de datos del nodo tras una primera ejecución). - Credencial de Ollama. Crea la credencial con la Base URL que te toque según la tabla de arriba (
http://ollama:11434con el Compose del ejemplo). - Clasificar. Añade un Text Classifier. En Input Prompt pon el texto del correo, por ejemplo
{{ $json.subject }} {{ $json.textPlain }}. Crea las categorías con nombre y descripción: "pedido" (alguien pide material o cambia un pedido), "factura" (nos envían o reclaman una factura). En opciones, activa When No Clear Match: Output on Extra, 'Other' Branch, para que lo dudoso salga por una rama "Other" en vez de perderse (por defecto, lo que no encaja se descarta). Engancha debajo un Ollama Chat Model. - Extraer los datos. De la salida "pedido", sale un Information Extractor con otro Ollama Chat Model. En Schema Type elige "Define using JSON Schema" y pega un esquema como este:
{
  "type": "object",
  "properties": {
    "cliente": { "type": "string", "description": "Nombre de la empresa o persona que escribe" },
    "numero_pedido": { "type": "string", "description": "Número de pedido si aparece; vacío si no" },
    "fecha_entrega": { "type": "string", "description": "Fecha pedida en formato AAAA-MM-DD; vacío si no hay" },
    "resumen": { "type": "string", "description": "Qué pide, en una frase" }
  },
  "required": ["cliente", "resumen"]
}- Guardar. Un nodo Google Sheets (o el de tu base de datos) que añade una fila con esos campos.
- Rama "Other" y facturas. Llévalas a donde las mire alguien: una etiqueta en el buzón o un aviso al equipo.
Antes de activarlo, pruébalo con diez correos reales y distintos, incluidos los raros.
Un detalle que se escapa: los subnodos procesan expresiones distinto que el resto. Según la misma página de problemas comunes, una expresión dentro de un subnodo siempre toma el primer elemento de la entrada. Pon las expresiones en el nodo principal (el Text Classifier o el Information Extractor), no en el Ollama Chat Model.
Pedir salida estructurada para que el flujo no se rompa
Un modelo de lenguaje, por defecto, escribe como quiere: hoy "Pedido", mañana "Es un pedido." y pasado un párrafo. El siguiente nodo del flujo espera un campo concreto, y eso es un fallo. La salida tiene que ser JSON con una forma fija.
Ollama lo soporta de serie. Según su página de salidas estructuradas, el parámetro format acepta "json" (cualquier JSON válido) o un esquema JSON completo, que obliga a una estructura concreta. La propia documentación da dos consejos: incluir también el esquema en el texto de la petición y bajar la temperatura a 0 para respuestas más repetibles. Si tienes Ollama instalado en el servidor, puedes probarlo sin n8n:
curl -s http://localhost:11434/api/chat -H "Content-Type: application/json" -d '{
  "model": "gemma4:e2b",
  "messages": [{"role": "user", "content": "Clasifica este correo como pedido, factura u otro y responde en JSON: Necesito 20 cajas para el viernes"}],
  "stream": false,
  "format": {
    "type": "object",
    "properties": { "categoria": { "type": "string", "enum": ["pedido", "factura", "otro"] } },
    "required": ["categoria"]
  },
  "options": { "temperature": 0 }
}'
En n8n no hace falta escribir esto a mano. El Information Extractor ya añade al modelo las instrucciones de formato a partir del esquema que le das, y el Text Classifier tiene la opción Enable Auto-Fixing, que devuelve al modelo el error si la respuesta no encaja y le pide que la corrija. En el Ollama Chat Model, dentro de Options, tienes Sampling Temperature (por defecto 0,7; para clasificar y extraer, ponla a 0) y Output Format, con los valores Default o JSON.
Aun así, valida antes de guardar. Un nodo If que compruebe que cliente no está vacío y que la fecha tiene diez caracteres cuesta un minuto y evita filas basura. JSON válido no significa datos correctos.
Qué modelo usar para cada tarea
Para automatizar, el modelo más grande que quepa suele ser mala idea: cada correo espera su turno y uno grande tarda más en cada uno. La tarea decide:
| Tarea | Qué modelo suele bastar |
|---|---|
| Clasificar en pocas categorías | Uno pequeño. Es la tarea más fácil |
| Extraer campos de un texto corto | Pequeño o mediano, según lo desordenado que llegue el texto |
| Resumir un documento largo | Mediano, y con contexto suficiente |
| Redactar respuestas que leerá un cliente | El mejor que te quepa, y con revisión humana |
El tamaño que cabe en tu tarjeta gráfica lo marca la VRAM, y la cuenta está en cuánta VRAM necesito para un modelo de IA. Prueba primero con el pequeño y sube solo si falla con tus correos reales.
Ojo con el contexto. En el Ollama Chat Model de n8n, la opción Context Length viene por defecto a 2048 tokens, según el código del nodo. Un correo largo con su hilo de respuestas no cabe, y el modelo trabaja con un texto cortado sin avisarte. Si procesas documentos o hilos largos, súbela, sabiendo que más contexto también ocupa más memoria de la tarjeta.
Qué pasa cuando el modelo tarda o falla
Un flujo que llama a un modelo va a fallar alguna vez: Ollama se reinicia, la tarjeta está ocupada o el modelo tarda en cargarse. Por defecto, Ollama descarga un modelo tras cinco minutos sin uso (el subnodo de n8n trae Keep Alive en 5m), y la siguiente petición espera a que vuelva a cargarse. Si los correos llegan a ratos, súbelo para evitar esa espera.
n8n tiene cuatro herramientas para los fallos, todas en su documentación:
- Retry On Fail, en los ajustes de cada nodo. Con Max Tries y Wait Between Tries (ms) decides cuántas veces reintenta y cuánto espera entre intentos, como explica la guía de límites de n8n. Actívalo en el nodo que habla con el modelo.
- On Error, también en los ajustes del nodo. "Continue (using error output)" saca el error por una rama propia, para mandarlo a revisión en vez de parar todo.
- Timeout Workflow, en los ajustes del flujo: cancela la ejecución si pasa del tiempo que marques. Evita ejecuciones colgadas horas esperando a un modelo que no responde.
- Error Workflow, en esos mismos ajustes: un segundo flujo que empieza con el nodo Error Trigger y avisa a quien toque cuando el principal falla.
Sin el último, un flujo roto puede pasar una semana sin que nadie se entere, hasta que lo nota un cliente.
Límites honestos
El modelo acierta mucho, no siempre: los correos ambiguos caen mal a veces, y por eso la rama "Other" existe y alguien tiene que mirarla. Un modelo pequeño también puede inventarse un dato: un número de pedido que suena bien, una fecha que nadie dijo. La descripción de cada campo del esquema ("vacío si no aparece") reduce ese riesgo, pero no lo elimina.
La regla que aplicamos: lo que sale hacia un cliente lo revisa antes alguien del equipo. Que el modelo prepare el borrador de respuesta está bien. Que lo envíe solo, no. Lo que va a facturación o a un pedido real, con validación y muestras revisadas cada semana al principio.
Cuándo compensa frente a una API
Una API de pago por uso no tiene nada que mantener. Si procesas pocos correos al mes y no son sensibles, suele ser lo más sensato: un servidor con tarjeta gráfica es un coste fijo que hay que amortizar.
El modelo propio empieza a compensar en dos situaciones. Volumen: cuando son miles de peticiones al mes, el coste fijo se reparte y deja de crecer con cada correo. Datos: cuando lo que procesas son pedidos, datos personales o contratos que no quieres enviar a un tercero, tenga la política de privacidad que tenga. En ese caso no es una cuestión de coste; tienes más detalle en qué datos no compartir con una IA. Y hay un motivo práctico: tu modelo no cambia de comportamiento porque un proveedor actualice el suyo.
Lo que esta guía no te cuenta
Montar el flujo es una tarde. Lo que viene después es lo que decide si sigue funcionando en seis meses:
- Actualizar sin romper flujos. n8n, Ollama y los modelos se actualizan por separado, y cualquiera de los tres puede cambiar un comportamiento. Actualiza uno cada vez y vuelve a pasar tus correos de prueba.
- Los controladores de la tarjeta. Cuando el sistema instala solo una actualización de los controladores de NVIDIA,
nvidia-smiresponde "Failed to initialize NVML: Driver/library version mismatch" hasta que reinicias, como documenta NVIDIA. Ollama sigue funcionando, pero sin la tarjeta: todo va muy lento y los flujos empiezan a agotar el tiempo de espera. - Flujos que fallan en silencio. Un flujo activo no es un flujo que funciona. Hace falta el flujo de errores y alguien que mire las ejecuciones fallidas.
- Mantenerlo cerrado. Un cambio para una prueba (un
portsen Ollama, un0.0.0.0) y la API vuelve a estar en internet. Se comprueba desde fuera, no se supone. - Copias de flujos y credenciales. n8n cifra las credenciales con una clave que crea en su carpeta de datos al primer arranque, según su documentación. Una copia de la base de datos sin esa clave te devuelve los flujos, pero no las credenciales.
Si prefieres no encargarte tú, lo montamos y lo mantenemos nosotros en un servidor con GPU, con Ollama cerrado a internet, vigilado y actualizado. Y si lo que necesitas es solo n8n, lo tienes en un VPS para n8n. Hablas con personas, no con un panel.
Preguntas frecuentes
¿Necesito una tarjeta gráfica para usar Ollama con n8n?
Para probar, no: Ollama funciona con el procesador. Para un flujo que procesa correos durante toda la jornada, sí conviene, porque sin GPU cada respuesta tarda mucho más y las ejecuciones se acumulan.
¿Puedo usar un Ollama que está en otro servidor?
Sí, siempre que llegue por una red privada o una VPN, no por internet abierto. Si está detrás de un proxy con contraseña, n8n la acepta en el campo API Key de la credencial.
¿Por qué n8n no ve mis modelos en el desplegable?
Casi siempre es la Base URL: n8n no llega a Ollama (revisa la tabla de direcciones) o Ollama no tiene ningún modelo descargado todavía. Prueba la dirección desde dentro del contenedor de n8n antes de tocar nada más.
Artículos relacionados
- Cómo instalar Ollama en un servidor y cerrarlo a internet
- Cuánta VRAM necesito para un modelo de IA
- Qué tareas automatizar con IA y por dónde empezar
- Open WebUI: un ChatGPT privado para tu equipo
¿Prefieres no encargarte tú?
Montamos tu IA en un servidor con GPU, la dejamos funcionando y la mantenemos nosotros.