Revisado en septiembre de 2026. Los modelos cambian cada pocos meses; los criterios, no.
La respuesta corta: no hay un mejor modelo, hay uno que encaja
El mejor modelo de IA abierto para tu empresa no existe en abstracto: es el más pequeño que resuelve bien tu tarea, en tu idioma, que cabe en tu máquina y cuya licencia te deja usarlo como lo vas a usar. Por eso esta guía no te da un ganador. Te da los filtros, en el orden en que los aplicamos nosotros, y un retrato de las seis familias que vas a encontrar al buscar: Llama (de Meta), Qwen (de Alibaba), Mistral, Gemma (de Google), DeepSeek y Phi (de Microsoft). Las versiones cambian cada pocos meses; la forma de decidir, no. Si llegas aquí sin tener claro qué piezas lleva una IA propia, empieza por el mapa general de IA privada en tu empresa y vuelve después.
Una advertencia antes de seguir: hablamos de licencias, pero esto no es asesoramiento legal. Te contamos lo que dicen los textos oficiales, con enlace. Si tu uso está en el borde, léete la licencia entera o consúltalo con quien te lleve lo legal.
Pesos abiertos no es lo mismo que código abierto
Casi todos estos modelos se anuncian como "open source", y casi ninguno lo es en sentido estricto. Lo que publican es el modelo ya entrenado (los pesos), no todo lo necesario para rehacerlo desde cero. Los pesos son el fichero de varios gigas con los miles de millones de números que el modelo aprendió. Con ellos lo ejecutas y lo ajustas, pero normalmente no te dan los datos con los que se entrenó ni todo el código del entrenamiento.
La Open Source Initiative, la organización que define qué es código abierto, publicó su definición de IA de código abierto (versión 1.0). Pide tres cosas: información suficiente sobre los datos de entrenamiento, el código completo para entrenar y ejecutar, y los parámetros (los pesos), todo con licencias aprobadas. La mayoría de modelos de esta guía solo cumplen la tercera, y algunos ni eso, porque su licencia pone condiciones propias.
En la práctica, para usarlo en tu empresa manda la licencia de los pesos. Por eso aquí decimos "modelos abiertos" y tratamos la licencia como criterio de primer nivel.
Los criterios, en orden
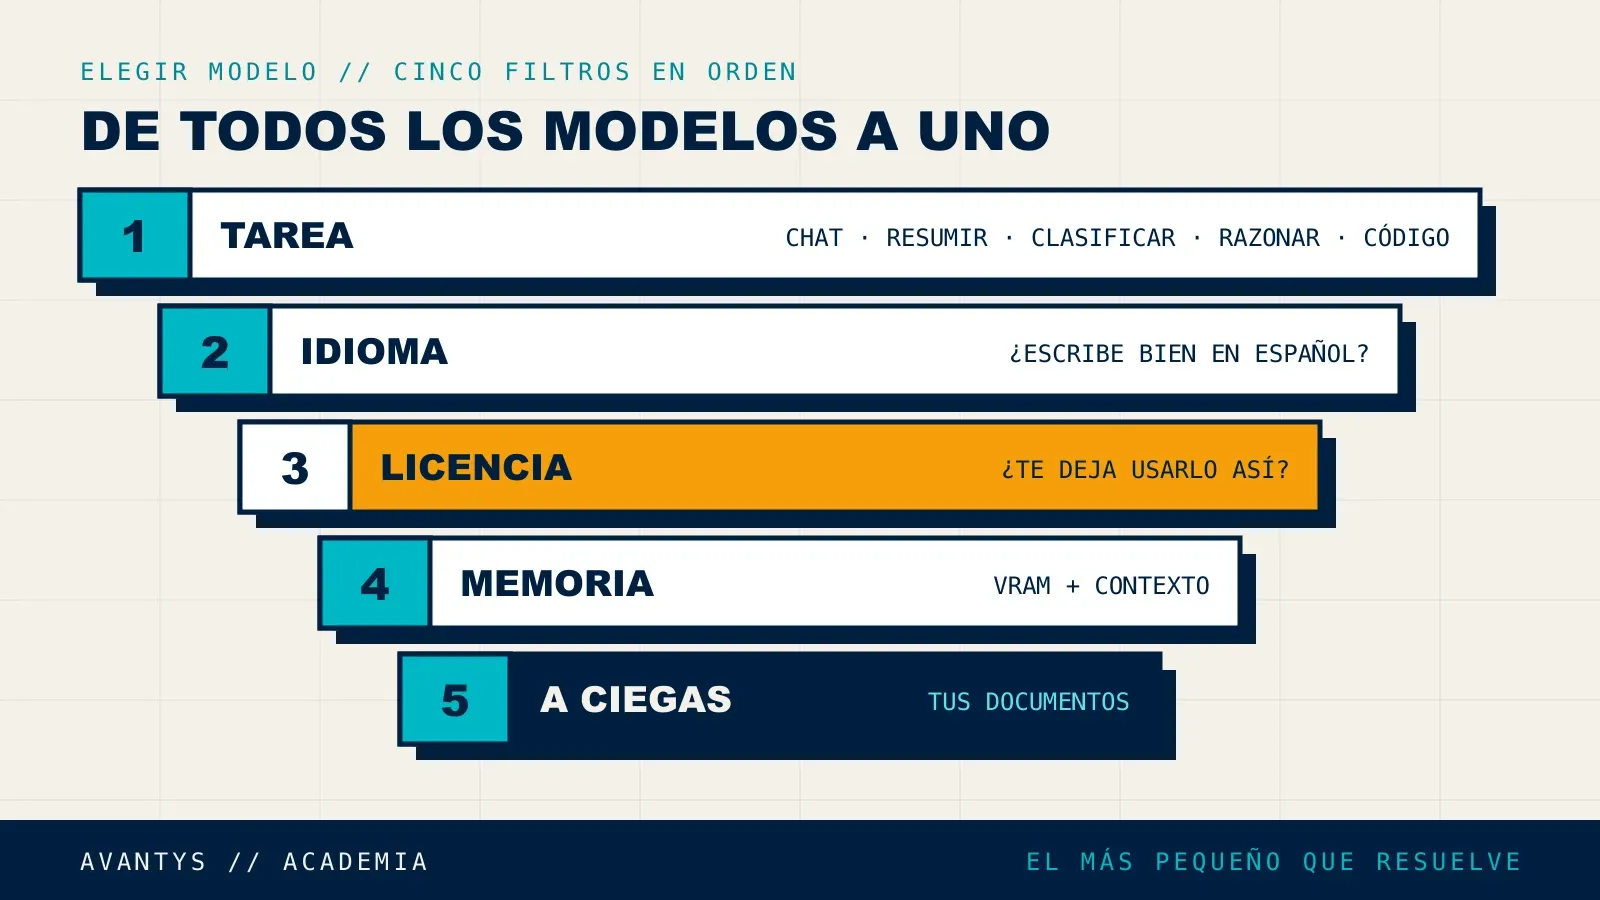
1. La tarea
Antes de mirar nombres, apunta qué va a hacer el modelo.
- Chat general y redacción: preguntas, borradores, reformular textos. Aquí se nota el tamaño.
- Resumir: actas, informes, hilos de correo. Pide sobre todo contexto largo (ver más abajo) y que no invente.
- Clasificar y extraer: etiquetar correos, sacar datos de facturas. Aquí un modelo pequeño brilla: tarea acotada y respuesta corta.
- Razonar: problemas de varios pasos, cuentas, análisis. Lo vemos con los modelos "razonadores".
- Programar: varias familias publican variantes para código; pruébalas antes que las generales.
Una tarea bien definida te permite un modelo más pequeño, y un modelo más pequeño es más rápido y cabe en una máquina más modesta.
2. El idioma
Tu equipo trabaja en español, y no todos los modelos van igual de bien en español. Algunos fabricantes lo dicen claro en la ficha. Microsoft, por ejemplo, avisa en la ficha de Phi-4 de que se entrenó sobre todo con texto en inglés, que en otros idiomas rinde peor y que no está pensado para uso multilingüe. En cambio, la ficha de su hermano pequeño, Phi-4-mini-instruct, sí incluye el español en su lista de idiomas. Dos modelos de la misma familia, dos respuestas distintas: por eso hay que leer la ficha de cada uno.
Qwen, en la ficha de Qwen3-8B, declara soporte para más de 100 idiomas y dialectos. Que un idioma esté en la lista no dice lo bien que lo escribe: eso solo lo sabes probando con tus textos.
3. La licencia (primer nivel, no letra pequeña)
La licencia decide si puedes usar el modelo en tu negocio y con qué condiciones. Hay dos grandes grupos:
- Licencias estándar permisivas, como Apache 2.0 o MIT. Son las mismas que usa muchísimo software libre. Permiten uso comercial, modificarlo y redistribuirlo, con obligaciones sencillas (conservar el aviso de licencia, sobre todo).
- Licencias propias del fabricante. Permiten uso comercial, pero con condiciones: un límite de usuarios, una política de usos prohibidos, obligaciones de atribución o de nombre si publicas algo derivado.
Para una pyme que usa el modelo por dentro, las licencias propias rara vez molestan. Pesan si lo integras en un producto que vendes o publicas un modelo ajustado.
4. Tamaño, memoria y contexto
El número con B del nombre (8B, 14B, 32B, 70B) son los miles de millones de parámetros. Más parámetros, más memoria de tarjeta gráfica (VRAM) y, por lo general, mejores respuestas en tareas difíciles. El modelo tiene que caber entero en la VRAM para ir con fluidez. Las cuentas completas, con tablas por tamaño y compresión, están en cuánta VRAM necesito para un modelo de IA.
Dos detalles que confunden al comparar fichas:
- Modelos de "mezcla de expertos" (MoE, en inglés). Tienen muchos parámetros en total pero solo usan una parte en cada palabra. DeepSeek-V3, por ejemplo, declara en su ficha 671B de parámetros en total y 37B activos por token. Van más rápido de lo que su tamaño sugiere, pero la memoria la pide el total, no la parte activa.
- El contexto máximo: cuánto texto puede tener delante a la vez (se mide en tokens, trozos de palabra). La ficha de Qwen3-8B indica 32.768 tokens de serie y hasta 131.072 con una técnica de ampliación que hay que configurar aparte. La de Phi-4 habla de 16.000. Si vas a pasarle contratos o manuales enteros, este dato te descarta candidatos. Y recuerda que el contexto largo también gasta VRAM.
5. La velocidad
Un modelo que tarda treinta segundos en contestar se deja de usar. La velocidad depende del tamaño, la compresión, la tarjeta y cuántas personas lo usan a la vez, así que se mide en tu máquina. Si lo montas con Ollama, en cómo instalar Ollama en un servidor explicamos cómo comprobar que usa la tarjeta y no el procesador, la causa más común de lentitud.
Las familias, una por una
Esta tabla describe cada familia, no una versión concreta. Las versiones que citamos son ejemplos de septiembre de 2026, y la licencia puede cambiar de una versión a otra dentro de la misma familia (ha pasado). Mira siempre la licencia en la ficha del modelo exacto que vas a descargar.
| Familia | Quién la publica | Licencia típica | Puntos fuertes | A vigilar |
|---|---|---|---|---|
| Llama | Meta | Licencia comunitaria propia | Muy extendida, mucho material y variantes | Límite de usuarios, atribución, política de usos |
| Qwen | Alibaba | Apache 2.0 en la mayoría de recientes | Muchos tamaños, multilingüe, variantes para código | Algunos modelos antiguos con licencia propia |
| Mistral | Mistral AI (Francia) | Apache 2.0 en buena parte de sus abiertos | Europeo, modelos pequeños eficientes | No todos sus modelos son abiertos ni Apache |
| Gemma | Apache 2.0 desde Gemma 4; antes, términos propios | Tamaños pequeños y medianos muy cuidados | Las versiones anteriores siguen con sus términos | |
| DeepSeek | DeepSeek | MIT o acuerdo propio, según el modelo | Fuerte en razonamiento | Modelos grandes; los "destilados" heredan otra licencia |
| Phi | Microsoft | MIT | Pequeños y rápidos | Algunos pensados sobre todo para inglés |
Llama (Meta)
Los modelos Llama salen con una licencia comunitaria propia de Meta. La de Llama 4, publicada en su repositorio oficial, permite uso comercial con tres condiciones que conviene conocer. Por encima de 700 millones de usuarios activos mensuales hay que pedir licencia a Meta (la cláusula famosa, que no te afecta). Si distribuyes el modelo o un producto hecho con él, debes mostrar "Built with Llama", y un modelo derivado debe llamarse empezando por "Llama". Y todo uso queda sujeto a su política de usos aceptables, que es lo que más te afecta por dentro.
Qwen (Alibaba)
La mayoría de los Qwen recientes se publican con Apache 2.0: lo indica, por ejemplo, la ficha de Qwen3-8B. Pero no todos. El Qwen2.5-72B-Instruct usa un acuerdo propio que pide licencia a partir de 100 millones de usuarios activos mensuales. Es el ejemplo perfecto de por qué no basta con saber la familia.
Mistral
Mistral AI publica en su documentación de modelos cuáles son abiertos y con qué licencia. En septiembre de 2026, buena parte de sus modelos abiertos (los Ministral pequeños, Mistral Small, Mistral Large) aparecen con Apache 2.0, y alguno con una licencia MIT modificada.
Gemma (Google)
Aquí hubo cambio. Las versiones anteriores de Gemma usan los términos de uso de Gemma: permiten uso comercial, pero incorporan una política de usos prohibidos, obligan a trasladar esas restricciones si redistribuyes el modelo y reservan a Google el derecho a restringir el uso que considere contrario al acuerdo. Con Gemma 4, Google anunció en su blog de código abierto (abril de 2026) que es la primera de la familia publicada con Apache 2.0. Misma marca, licencias distintas según la versión.
DeepSeek
La ficha de DeepSeek-R1 indica licencia MIT para el código y los pesos, uso comercial incluido. Ojo con dos cosas. DeepSeek-V3 lleva el código en MIT pero el modelo bajo un acuerdo propio de DeepSeek, según su ficha. Y los modelos "destilados" de R1 (versiones pequeñas entrenadas a partir de Qwen o Llama) conservan las obligaciones de la licencia del modelo base: si el destilado viene de Llama, arrastra la licencia de Llama. Sus modelos principales son enormes: en una máquina de empresa normal, lo realista son los destilados.
Phi (Microsoft)
Los Phi son modelos pequeños con licencia MIT, según la ficha de Phi-4. Van bien para tareas acotadas en máquinas modestas. El punto a vigilar es el idioma, como vimos: comprueba en la ficha de cada versión si el español está entre los soportados.
Los modelos "razonadores"
Algunos modelos piensan antes de contestar: escriben primero un razonamiento interno, paso a paso, y después la respuesta. Qwen3, por ejemplo, permite activar y desactivar ese modo de pensar, según su ficha. DeepSeek-R1 nació justo para esto.
Razonan mejor en problemas de varios pasos, pero son más lentos y gastan muchos más tokens, porque todo ese razonamiento también se genera. Úsalos donde el razonamiento se nota (análisis, cálculos, decisiones con varias condiciones) y desactívalos para lo rutinario, como clasificar correos o resumir un acta.
Cómo probarlo: tres candidatos y una prueba a ciegas
Así lo hacemos nosotros, y se hace en un par de días:
- Elige tres candidatos que pasen los filtros: tarea, idioma, licencia y memoria. Mejor de familias distintas, y al menos uno pequeño.
- Prepara veinte o treinta casos reales: tus documentos y las preguntas que tu equipo hace de verdad, no ejemplos de internet que los modelos ya han visto.
- Pasa los mismos casos por los tres con la misma configuración.
- Puntúa a ciegas. Que alguien que conoce el tema valore las respuestas (bien, regular, mal) sin saber qué modelo dio cada una. Así no decide la fama del nombre.
- Quédate con el más pequeño que resuelve. Si el de 8B acierta igual que el de 32B en tus casos, el de 8B es tu modelo: más rápido, más barato de mover y con sitio libre en la tarjeta.
Guarda esos casos. Son tu examen para el día que salga una versión nueva y quieras saber si merece la pena cambiar.
Sesgos y errores: revisión humana siempre
Todos estos modelos se equivocan, y con seguridad: inventan un dato o una cita con la misma soltura con la que aciertan. También arrastran sesgos de los textos con los que se entrenaron. Que el modelo corra en tu servidor protege tus datos, pero no lo hace más fiable.
La regla práctica: cualquier cosa que salga hacia un cliente, que tenga efectos legales o que mueva dinero la revisa una persona. El modelo prepara el borrador; alguien de tu equipo lo firma. Sobre qué datos conviene no pasarle, tienes qué datos de tu empresa no deberías compartir con una IA.
Por qué no puedes instalar ChatGPT o Claude en tu servidor
Es la pregunta que más nos hacen. Los modelos que hay detrás de ChatGPT, Claude o Gemini no se publican: sus fabricantes solo los ofrecen como servicio, a través de su web o de su API. No hay fichero de pesos que descargar, así que no hay forma legal de ejecutarlos en tu máquina.
Hay un matiz honesto. Algunos de esos fabricantes publican también modelos abiertos, distintos de los de su servicio principal. OpenAI publicó gpt-oss con licencia Apache 2.0, según su repositorio oficial, y Google publica Gemma aparte de Gemini. Se instalan como cualquier modelo abierto, pero no son "ChatGPT en tu servidor": pásalos por la misma prueba a ciegas.
Lo que esta guía no te cuenta
Elegir el modelo es el principio. Lo que viene después es lo que decide si la IA sigue funcionando dentro de seis meses:
- Cambiar de modelo sin romper lo que ya lo usa. Saldrá uno mejor. Si tienes flujos o integraciones hechas para el actual, cambiarlo a lo loco rompe cosas: se prueba el nuevo con tu examen, al lado del viejo, y se cambia cuando gana.
- Actualizar sin romper. Los controladores de NVIDIA tienen una parte que se carga al arrancar y otra que usan los programas. Si una actualización automática cambia una y la otra sigue en memoria, aparece "Failed to initialize NVML: Driver/library version mismatch" y el modelo deja de ver la tarjeta. NVIDIA lo documenta: lo habitual es reiniciar para cargar el controlador nuevo. Mejor controlar cuándo pasa que descubrirlo porque todo va lento.
- Cerrarlo a internet. Un servidor de modelos abierto a la red es una puerta a tu máquina y a lo que le pasas. Debe responder solo a quien tú decidas.
- Copias. De la configuración, de los modelos que hayas ajustado y de tu colección de casos de prueba. Los modelos públicos se vuelven a descargar; tu trabajo no.
Si prefieres no encargarte tú, lo elegimos contigo, lo montamos y lo mantenemos nosotros. Hacemos la prueba a ciegas con tus documentos y, cuando sale un modelo mejor, lo probamos antes de cambiarlo.
Preguntas frecuentes
¿Puedo usar un modelo abierto gratis en mi empresa?
La mayoría de las licencias de esta guía permiten uso comercial sin pagar al fabricante. Lo que cuesta es la máquina donde corre y el trabajo de mantenerla. Aun así, lee la licencia del modelo concreto: algunas tienen condiciones de usos prohibidos o de atribución.
¿Qué licencia me da menos problemas?
Apache 2.0 y MIT son las más sencillas: son licencias estándar, conocidas y con pocas obligaciones. Las licencias propias (Llama, versiones anteriores de Gemma, algunas de Qwen y DeepSeek) también permiten uso comercial, pero con condiciones que hay que leer.
¿Un modelo más grande es siempre mejor?
No. En tareas acotadas, como clasificar o extraer datos, un modelo pequeño bien elegido suele rendir igual y va mucho más rápido. El tamaño se nota más en conversación abierta y en razonamiento.
Artículos relacionados
- Cuánta VRAM necesito para un modelo de IA
- Cómo instalar Ollama en un servidor
- Qué datos de tu empresa no deberías compartir con una IA
- Qué tareas automatizar con IA
¿Prefieres no encargarte tú?
Montamos tu IA en un servidor con GPU, la dejamos funcionando y la mantenemos nosotros.