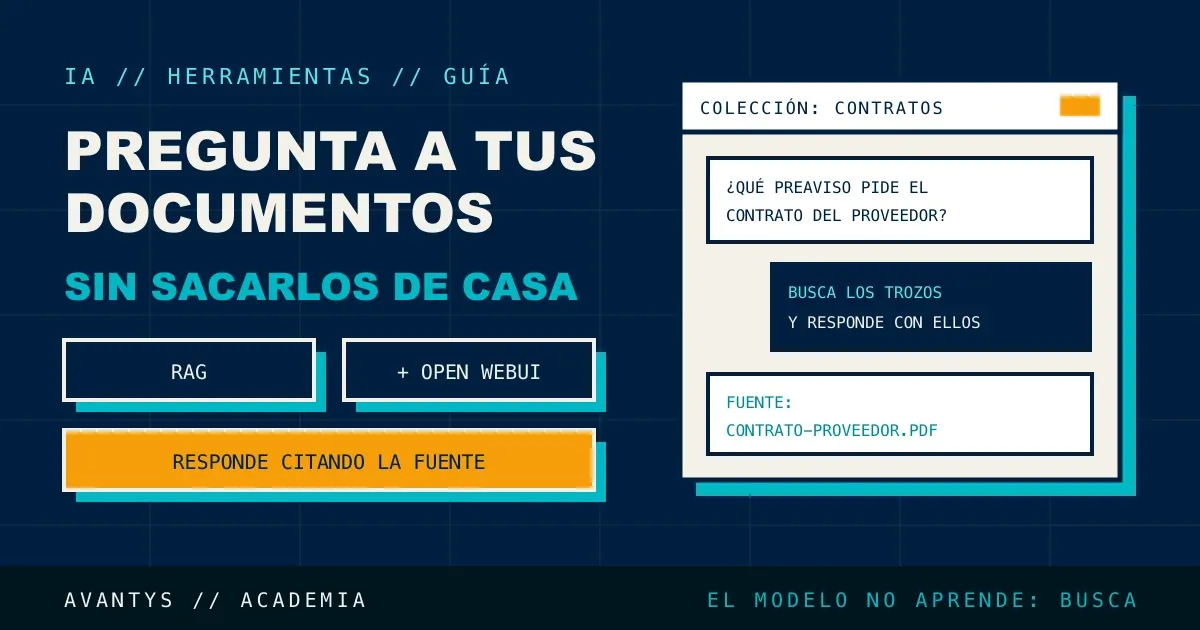
Puedes preguntarle a una IA por tus contratos, manuales o expedientes en lenguaje normal, y que te conteste citando el documento, sin que esos ficheros salgan de tu servidor. La técnica se llama RAG, y lo primero que hay que saber es lo que no hace: el modelo no "aprende" tus documentos. Lo que ocurre es más sencillo. Cuando preguntas, un buscador localiza los trozos de tus documentos que tienen que ver con la pregunta, y se los pasa al modelo junto a ella para que responda con eso delante. Aquí te explicamos cómo funciona, cómo montarlo con lo más sencillo que conocemos (las bases de conocimiento de Open WebUI con Ollama), qué documentos funcionan, quién ve qué y dónde se equivoca.
Revisado en septiembre de 2026. Cada paso lleva enlace a la documentación oficial; si algo no cuadra con lo que ves en pantalla, manda la fuente.
Qué es RAG, en llano
RAG son las siglas en inglés de "generación aumentada por recuperación". Traducido: antes de contestar, se busca; y lo que se encuentra se le da al modelo para que conteste con ello. Piensa en un empleado nuevo muy listo que no conoce tu empresa. No sabe qué dice la cláusula de rescisión con tu proveedor, pero si alguien le pone delante esas tres páginas del contrato, te lo explica bien. RAG es ese alguien que va al archivo y le deja en la mesa las páginas correctas.
Eso tiene dos consecuencias que conviene tener claras desde el principio. La primera: el modelo no cambia. No se entrena con tus documentos, no se los queda y no los recuerda en la siguiente conversación. La segunda: la calidad de la respuesta depende sobre todo de la búsqueda. Si el buscador no encuentra el trozo bueno, el modelo contesta con lo que tiene, y lo que tiene puede ser nada. La documentación de Open WebUI lo resume así en su guía de problemas con documentos: el modelo no se inventa cosas porque sea malo, sino porque nunca le llegó el contenido correcto.
Por qué no basta con pegar el PDF en el chat
Con un documento corto funciona. El problema aparece con el archivo de verdad: doscientos contratos, un manual de cuatrocientas páginas, los expedientes de un año. Hay tres límites.
El contexto tiene tope. El modelo solo puede "leer" una cantidad de texto a la vez, lo que se llama ventana de contexto. Y en un servidor propio suele ser más pequeña de lo que crees. Según la documentación de Ollama, por defecto usa un contexto de 4.000 tokens (unas pocas páginas) si la tarjeta gráfica tiene menos de 24 GiB de memoria, 32.000 entre 24 y 48 GiB, y 256.000 a partir de 48 GiB. Un manual entero no entra.
Más contexto cuesta memoria. Se puede subir ese tope, pero la misma página avisa de que un contexto mayor necesita más memoria de la tarjeta gráfica (VRAM). Y cada pregunta obliga al modelo a leerlo todo otra vez, así que también va más lento. Si quieres hacer números de memoria, los tienes en cuánta VRAM necesita cada modelo.
Sin citas no puedes comprobar nada. Si metes cuarenta páginas y el modelo te da una respuesta, no sabes de dónde la ha sacado. Con RAG, cada respuesta viene de trozos concretos, y la herramienta te enseña cuáles. Eso es lo que convierte un chat simpático en algo que se puede usar para trabajar.
Las cuatro piezas
Open WebUI trae las cuatro montadas, pero entenderlas te ayuda a saber por qué falla cuando falla.
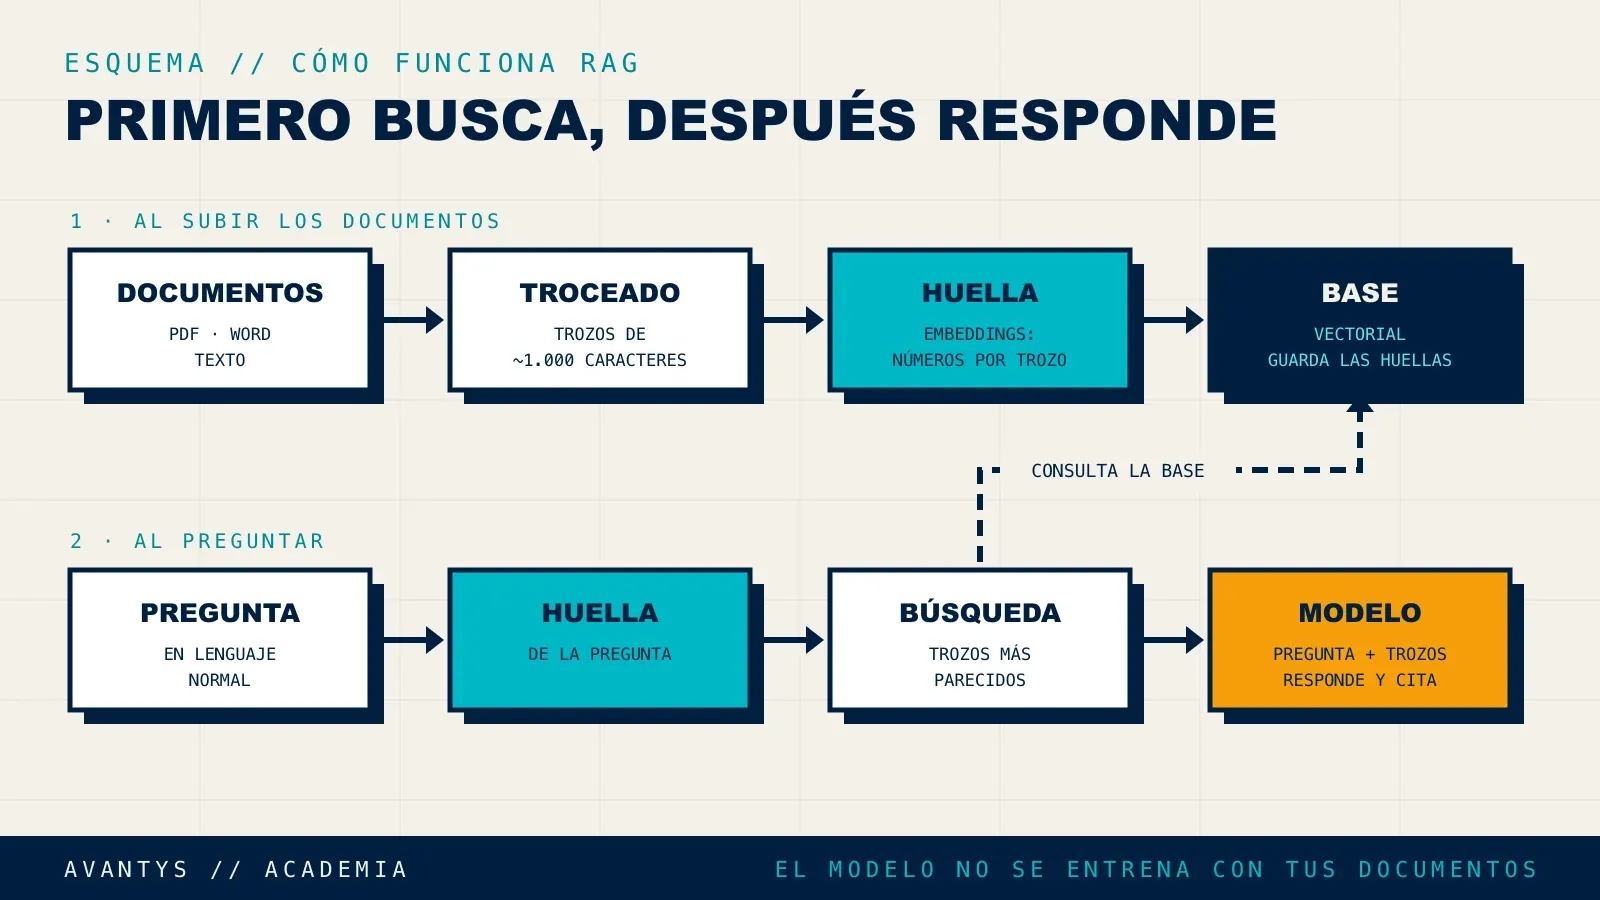
- Troceado. Cada documento se parte en trozos de un tamaño fijo, por ejemplo unos mil caracteres. Si el trozo es muy pequeño pierde el sentido; si es muy grande, se come el contexto.
- La "huella" de cada trozo. Un modelo pequeño y especializado, llamado modelo de embeddings, convierte cada trozo en una lista de números que representa de qué habla. Dos textos que dicen lo mismo con palabras distintas acaban con huellas parecidas. Así el buscador encuentra "fin del contrato" aunque el documento diga "rescisión". La documentación de Ollama lo define como convertir texto en vectores numéricos que se guardan en una base de datos vectorial.
- La base vectorial. Es donde se guardan esas huellas, y sabe encontrar rápido las más parecidas a la huella de tu pregunta.
- El modelo. El de siempre, el que conversa. Recibe tu pregunta más los trozos encontrados y redacta la respuesta.
Open WebUI permite además una búsqueda híbrida: combina la de huellas con la clásica por palabras (BM25) y reordena los resultados, según su página de RAG. Ayuda mucho con nombres propios, referencias y números de expediente, que la búsqueda por significado a veces pasa por alto.
Cómo montarlo con Open WebUI, paso a paso
Damos por hecho que ya tienes Ollama con un modelo funcionando y Open WebUI delante, con usuarios y HTTPS. Si no, empieza por cómo instalar Ollama en un servidor y cómo montar un ChatGPT privado con Open WebUI, y vuelve aquí.
1. Saca la huella a Ollama
De serie, Open WebUI calcula las huellas con un modelo pequeño (all-MiniLM-L6-v2) que carga dentro de su propio proceso. La guía de rendimiento avisa de que consume unos 500 MB de RAM por proceso y recomienda, para uso con varias personas, que ese trabajo lo haga Ollama. Nosotros además elegimos un modelo de embeddings multilingüe, porque tus documentos están en español. Qwen3-Embedding, según su ficha en Ollama, admite más de 100 idiomas, y su versión más pequeña pesa unos 640 MB:
ollama pull qwen3-embedding:0.6bDespués, en Open WebUI, entra en el panel de administración, ajustes, apartado Documents. Ahí eliges Ollama como motor de embeddings y escribes el nombre del modelo. Un aviso importante de la documentación de RAG: si cambias el modelo de embeddings cuando ya tienes documentos subidos, hay que reindexarlos todos (hay un botón Reindex en ese mismo apartado). Las huellas de un modelo no se entienden con las de otro. Por eso conviene decidirlo antes de subir nada.
2. Crea la colección
En Open WebUI, a los conjuntos de documentos los llaman bases de conocimiento. Según su documentación, se crean en Workspace > Knowledge, con el botón Create, dándoles nombre y descripción.
Haz colecciones pequeñas y con sentido: "Contratos de proveedores", "Manual de calidad", "Procedimientos de RR. HH.". Una colección gigante con todo mezclado da peores búsquedas y, sobre todo, complica los permisos, que veremos enseguida.
3. Sube los documentos
Dentro de la colección, Add Content te deja subir ficheros sueltos, una carpeta entera (Upload directory), una página web o texto pegado. Hay también Sync directory, que refleja una carpeta y, al volver a sincronizar, sube lo nuevo, sustituye lo modificado y quita lo borrado.
Empieza con cinco o diez documentos que conozcas bien (la documentación recomienda probar primero con PDF de texto, no escaneados). Así sabrás si las respuestas son buenas.
4. Pregunta
Hay dos formas de usarla, según la misma página. La rápida: en cualquier conversación escribes # y eliges la colección. La cómoda para el equipo: en Workspace > Models editas un modelo, le asignas la colección y le pones un nombre claro, por ejemplo "Asistente de contratos". Quien lo elija ya pregunta sobre esos documentos sin hacer nada más.
5. Ajusta el contexto
Si las respuestas salen pobres aunque el documento contiene la información, casi siempre es el contexto. La guía de problemas explica que con el tope de 4.000 tokens de Ollama solo una parte de lo encontrado llega al modelo. Para modelos locales con poco contexto, propone trozos de unos 1.000 caracteres y entre 3 y 5 trozos por pregunta (el ajuste "Top K"). Con memoria de sobra, puedes subir el contexto de Ollama con la variable OLLAMA_CONTEXT_LENGTH. En un servidor Linux donde Ollama corre como servicio, se añade como indica su FAQ:
sudo systemctl edit ollama.serviceY en el fichero que se abre:
[Service]
Environment="OLLAMA_CONTEXT_LENGTH=16384"
Guarda, y aplica con sudo systemctl daemon-reload y sudo systemctl restart ollama. Más contexto es más VRAM: comprueba con nvidia-smi que el modelo sigue cabiendo en la tarjeta.
Qué documentos funcionan bien y cuáles no
RAG va bien con texto corrido: contratos, manuales, procedimientos, políticas, actas o fichas en PDF generado desde un procesador de textos. Son frases completas y cada trozo se entiende solo. Con lo demás conviene saber qué esperar antes de prometer nada al equipo:
| Documento | Qué pasa | Qué hacer |
|---|---|---|
| PDF escaneado | Es una foto de la página: no hay texto que leer | Pasarle reconocimiento de caracteres (OCR) y revisar el resultado |
| Tablas largas | Al trocear, la cabecera queda en un trozo y las filas en otro | Tablas cortas o pasarlas a texto |
| Hojas de cálculo | RAG busca texto, no suma columnas ni filtra filas | Para "cuánto facturamos en marzo", otra herramienta |
| Varias versiones del mismo documento | La búsqueda puede traer la cláusula vieja | Subir solo la vigente |
Para los escaneos, Open WebUI tiene una opción para extraer el texto de las imágenes de los PDF y admite motores de extracción como Tika o Docling, según la guía de problemas. Un OCR malo produce texto malo, y la IA contestará con él. Y para las hojas de cálculo, la propia documentación de Knowledge remite a otra función de análisis de ficheros.
Que responda citando la fuente
Una respuesta sin fuente no se puede comprobar. Open WebUI añade citas a las respuestas que usan documentos: debajo aparece de qué fichero salió cada parte, y puedes abrir el trozo exacto. La documentación de Knowledge matiza algo importante: la precisión de la cita depende de lo bien que se extrajo el texto del documento.
Nuestro consejo es convertirlo en costumbre del equipo: la respuesta orienta, el documento decide. Si la respuesta va a acabar en un correo a un cliente, en una decisión o en un escrito, se abre la cita y se lee el original. En las instrucciones del modelo que creaste en el paso 4 puedes añadir algo como "si no encuentras la respuesta en los documentos, dilo; no la deduzcas". Ayuda, pero no lo garantiza.
Quién puede ver cada colección
Aquí es donde esto puede hacer daño. Si metes las nóminas en una colección que ve toda la empresa, cualquiera puede preguntar por el sueldo de un compañero, y el modelo contestará citando la fuente.
Según la documentación de grupos, las bases de conocimiento son privadas por defecto: sin permisos añadidos, solo las ve quien las creó. Puedes dar acceso de lectura (verla y usarla) o de escritura (lo mismo que el dueño) a personas o grupos concretos. Y ojo con "pública": significa todos los usuarios con cuenta, no solo tu departamento. La misma página explica que los administradores ven las colecciones ajenas mientras esté activado BYPASS_ADMIN_ACCESS_CONTROL, que viene encendido de serie. Si eso no encaja con tu política, se desactiva.
Recuerda también que el permiso de la colección no basta si el modelo que la lleva asignada lo ve todo el mundo. Revisa las dos cosas. Y antes de subir nada, repasa qué datos no conviene meter en una IA, aunque esté en tu servidor. La AEPD publicó en noviembre de 2025 su política interna de uso de IA generativa; no te obliga, pero sus preguntas (qué datos entran, dónde se guardan, cuánto tiempo, quién accede) son un buen criterio.
Cuando cambian los documentos
Si el manual tiene versión nueva y la colección sigue con la vieja, el modelo contestará con la vieja, y con cita, que da más confianza a una respuesta equivocada.
La forma más cómoda es Sync directory: según la documentación, cuando un fichero cambia, la entrada antigua se retira de la colección y se sustituye por la nueva; los borrados desaparecen y los ficheros ocultos (los que empiezan por punto) se ignoran. Si subes a mano, borra la versión vieja antes de subir la nueva.
En la práctica funciona nombrar a alguien responsable de cada colección, como ya lo hay de la carpeta compartida, y revisar cada cierto tiempo qué ha caducado.
Otras herramientas
Open WebUI no es la única opción. AnythingLLM, por ejemplo, según su documentación, funciona con modelos locales como Ollama, organiza los documentos en espacios de trabajo y tiene una versión de escritorio para una persona y otra con Docker para equipos. Si ya usas Open WebUI, lo razonable es no añadir otra pieza que mantener.
Límites honestos
Inventa cuando no encuentra. Si la búsqueda no trae el trozo correcto, muchos modelos no dicen "no lo sé": rellenan con algo plausible. Las citas te ayudan a detectarlo, pero solo si alguien las mira.
Los modelos pequeños razonan poco. Encontrar un dato en un contrato lo hacen bien. Comparar cinco contratos y decirte cuál tiene la penalización más dura, bastante peor. La calidad del modelo sigue importando, y el modelo que cabe en tu tarjeta es el que es.
Hay que probar con preguntas reales. Antes de abrirlo al equipo, prepara veinte preguntas que la gente hace de verdad, con su respuesta correcta y el documento donde está. Pásalas, apunta cuántas acierta y cuántas cita bien. Cambia un ajuste, repite. Sin esa prueba no sabes si funciona; solo sabes que responde.
Lo que esta guía no te cuenta
Montarlo es la parte corta. Lo que viene después:
- Actualizar sin romper. Open WebUI cambia a menudo, y el servidor también. Si tiene GPU NVIDIA y los controladores se actualizan solos, es habitual que Ollama deje de usar la tarjeta con el error
Failed to initialize NVML: Driver/library version mismatch. Según el soporte de NVIDIA, suele resolverse reiniciando, pero hasta entonces todo tira de procesador y va lentísimo. - Cerrarlo a internet. Ollama no trae contraseña. En enero de 2026, SentinelOne y Censys encontraron unas 175.000 máquinas con Ollama abierto en 130 países. Con tus contratos detrás, no quieres ser una de ellas.
- Vigilar que responde. Que la web cargue no significa que la búsqueda funcione. Una prueba periódica con una pregunta de respuesta conocida te avisa antes que el equipo.
- Copias. Las colecciones, las huellas y los permisos viven en los datos de Open WebUI. Copias programadas, fuera del servidor y probadas.
- Disco. Documentos, huellas, modelos y versiones viejas de contenedores. Se llena solo y en silencio.
Si prefieres no encargarte tú, lo montamos y lo mantenemos nosotros en un servidor con GPU: Ollama, Open WebUI, las colecciones, los permisos, las copias y las actualizaciones, con un equipo que responde cuando algo falla.
Preguntas frecuentes
¿La IA aprende de mis documentos?
No. Con RAG el modelo no se entrena ni se modifica. En cada pregunta recibe unos trozos de tus documentos, responde y los olvida. Si quitas un documento de la colección, deja de usarlo en ese momento.
¿Cuántos documentos puedo meter?
La documentación de Open WebUI no fija un límite. El límite práctico es tu servidor: más disco, más proceso al subirlos y búsquedas que afinar. Empieza pequeño y mide.
¿Sirve para escaneos antiguos?
Solo con un buen reconocimiento de caracteres (OCR) antes. Sin él, el sistema no ve texto. Revisa unas páginas del resultado antes de fiarte.
¿Puede cada departamento ver solo lo suyo?
Sí. Las colecciones son privadas por defecto y se comparten con grupos concretos, en lectura o escritura. Ten en cuenta que los administradores las ven salvo que desactives ese permiso.
Artículos relacionados
- Open WebUI: cómo montar un ChatGPT privado para tu equipo
- Cómo instalar Ollama en un servidor y cerrarlo a internet
- Cuánta VRAM necesitas para un modelo de IA
- Qué datos de tu empresa no deberías compartir con una IA
¿Prefieres no encargarte tú?
Montamos tu IA en un servidor con GPU, la dejamos funcionando y la mantenemos nosotros.